利益揭露:我是 DigitalOcean 的 Solutions Architect,所以文中提到 DigitalOcean 產品時,是「業內人的觀點」而非中立第三方——這些地方我都會明確標示,其餘分析則盡量保持廠商中立。以下皆為個人觀點。
我在準備 telc Deutsch B1,最擔心的是口說:十六分鐘、兩位考生加一位考官,中間沒時間查任何東西。慕尼黑晚上十一點很難找到練習夥伴,所以我自己做了一個。Losreden(程式碼放在叫 sprechtest 的 repo 裡)在瀏覽器裡跑一場模擬的 telc 口試:一位掌握流程和時間的考官、一位會跟你討論甚至反駁你的「第二位考生」,最後給一份照 telc 評分標準和配分寫成的報告。我每天都在用。
這篇文章寫它怎麼建在 LiveKit Agents 1.8.11 上、花我最多時間的五個問題、我做的取捨,以及練一次要多少錢。第二篇專講一個問題:對一個停下來思考的人,AI 考伴什麼時候該開口。每個數字都來自 repo 裡的執行記錄、commit 或設定檔。講到 LiveKit 內部行為時,我會註明是讀文件得知,還是從安裝的 SDK 和記錄觀察到的。
TL;DR
- Losreden 是在瀏覽器裡跑的 telc B1 口試模擬,建在 LiveKit Agents 1.8.11 上:一個
AgentSession、兩個聲音(照稿念的考官和 LLM 扮演的搭檔)、一個隱形 observer,最後照 telc 自己的評分標準出報告。 - 我試過的每個模型都無視「一到三句」。 改在程式裡截斷回覆(
llm_node)後,考生在三個部分的發言字數占比從 54 / 42 / 48 % 升到 71 / 62 / 74 %。 - 量測工具要在實際執行的地方驗證。 平滑的 frame 時鐘在 localhost 贏過到達時間戳(SD 5 ms 對 25 ms),到 LiveKit Cloud 上反而輸(90 ms 對 3–5 ms)。
- 安靜的預設值花掉最多除錯時間: agent 聽不到其他 agent(
participant_kinds),以及沒有can_update_own_metadata時set_attributes()什麼都不做。 - 延遲: 31 輪搭檔回覆的
e2e_latency中位數是 1.34 秒,其中大部分是刻意的一秒等待。 - 成本: 一場完整的 16 分鐘練習實測 0.70 美元;LLM 評審是最大一項,約占 40 %。
為什麼要做
telc B1 口試分三部分。Teil 1 互相認識(約 3 分鐘)。Teil 2 兩位考生各讀了一篇立場相反的短文,先各自轉述,再一起討論(約 6 分鐘)。Teil 3 一起規劃一件事(約 6 分鐘)。telc 允許「單人考試」(Einzelprüfung):一位考官主持,另一位考官扮演你的搭檔。這個形式很適合用軟體做:主持人用一個照稿念的聲音,搭檔用一個 LLM 的聲音。
我要的練習工具:
- 真實的結構和時間,用 telc 考官的原句,不是自由聊天。
- 一位講話像 B1 考生的搭檔,而且留空間讓我講。
- 照 telc 標準的回饋:Ausdrucksfähigkeit、Aufgabenbewältigung、Formale Richtigkeit、Aussprache,各分 A–D 等級,總分 75。
- 不存音檔。 我的聲音只送去語音辨識,不去別的地方。
架構
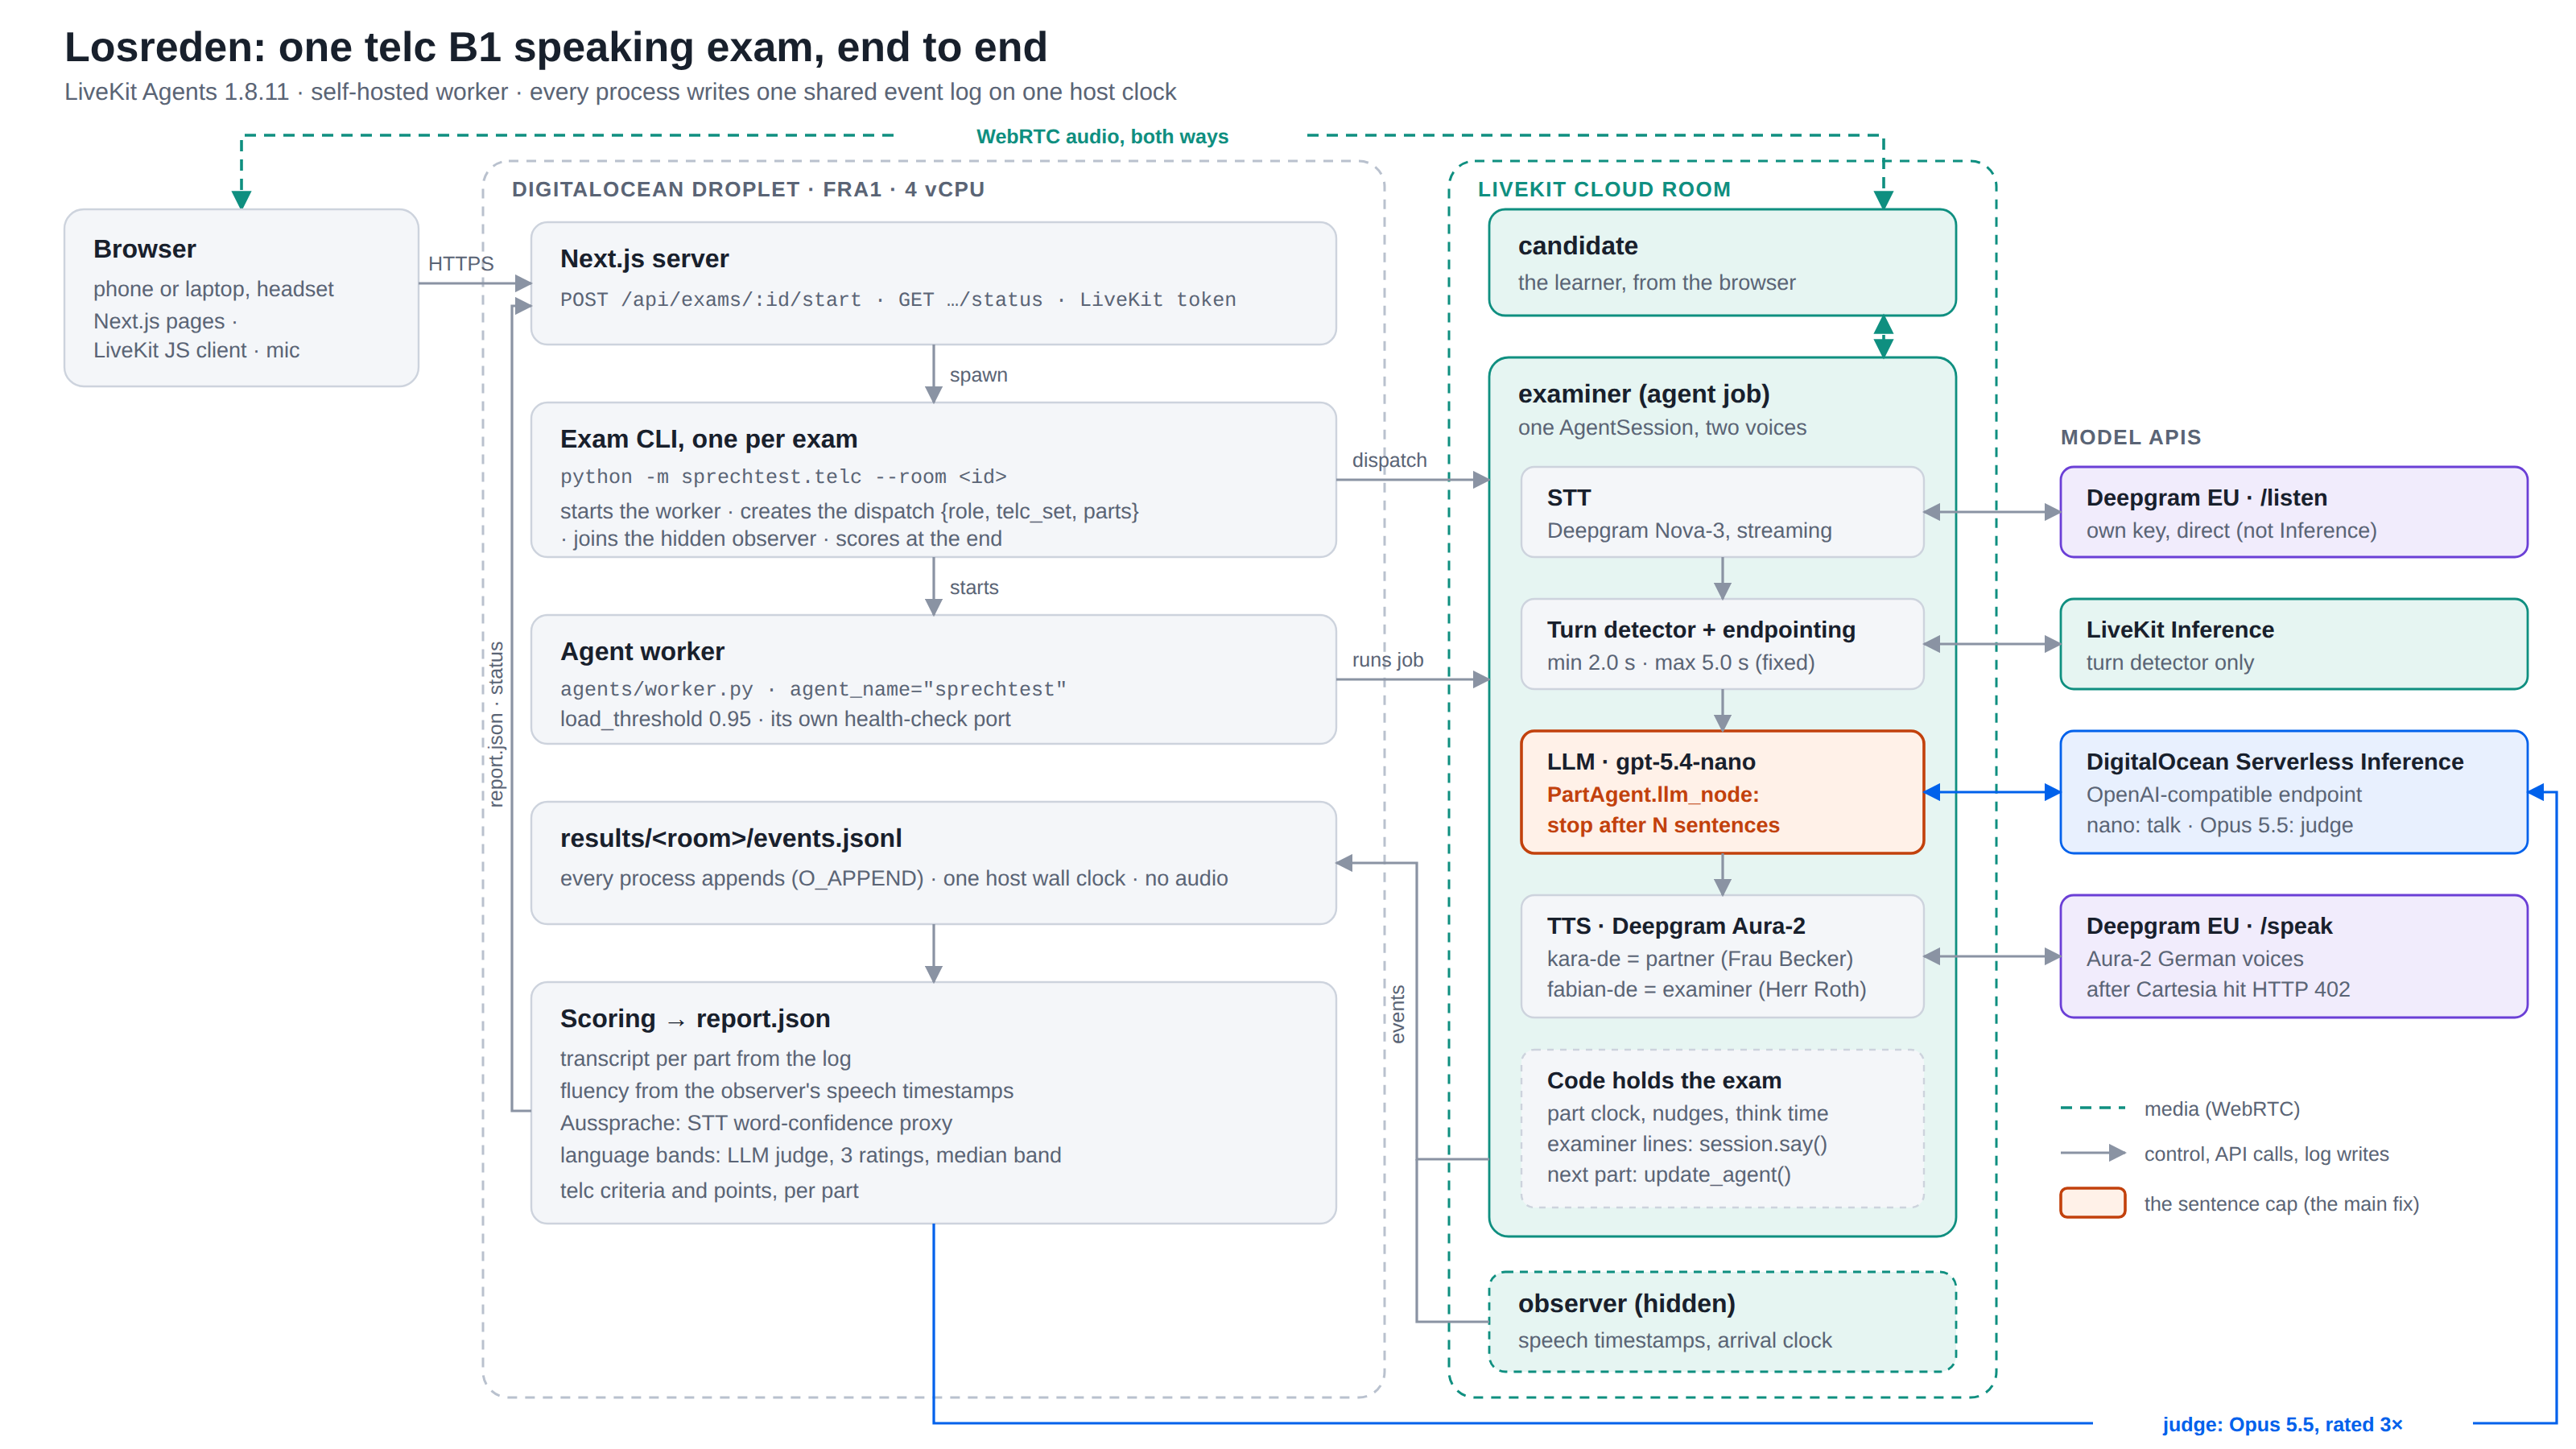
一場考試,從點擊到報告:
- 瀏覽器對一個小小的 Next.js 伺服器:登入、選題組、在準備時間讀題目卡、按開始。
POST /api/exams/<id>/start每場考試起一個 CLI:python -m sprechtest.telc --candidate human --room <id>。CLI 啟動 agent worker(agents/worker.py,以agent_name="sprechtest"註冊),建立一個明確的 dispatch,metadata 是{role, telc_set, parts},讓隱形的 observer 加入房間,然後等考試結束。- 瀏覽器拿伺服器發的 token,以
candidate身分加入 LiveKit Cloud 房間。 - 考官 job 是單一個
AgentSession:Deepgram Nova-3 STT → LiveKit 的 turn detector →gpt-5.4-nano→ Deepgram Aura-2 TTS。它有兩個聲音:照稿念的考官 Roth 先生(aura-2-fabian-de),和由 LLM 扮演的搭檔 Becker 女士(aura-2-kara-de)。 - 所有程序都寫同一個
events.jsonl,用O_APPEND,時間戳來自同一台主機的時鐘:CLI、agent、observer 都是。不存音訊,只有文字和時間戳。 - 考官說完結束語後,CLI 對記錄評分:每部分的逐字稿、從 observer 時間戳算的流暢度、用 Deepgram 字詞信心值當發音代理指標,以及由 Claude Opus 5.5 擔任評審給的語言等級,評三次、每個標準取中位數。網頁讀
report.json。
模型和它們跑在哪裡:
| 工作 | 模型 | 路徑 |
|---|---|---|
| 語音辨識 | Deepgram Nova-3 | 直連 Deepgram EU 端點,自己的 key |
| 聲音 | Deepgram Aura-2(德語) | 直連 Deepgram EU 端點 |
| 換人說話偵測 | LiveKit turn detector | LiveKit Inference |
| 搭檔/考官 LLM | openai-gpt-5.4-nano | DigitalOcean Serverless Inference(相容 OpenAI) |
| 評審 | anthropic-claude-opus-5.5 | DigitalOcean Serverless Inference |
我在 DigitalOcean 工作,所以模型都跑在那裡。DigitalOcean 的端點相容 OpenAI,所以 LLM 就是 LiveKit 的 openai.LLM plugin 換一個 base_url。config/default.yaml 裡每個模型區塊都吃 via: digitalocean | inference | direct。這個設計後面救了我兩次。
一個 session,兩個角色
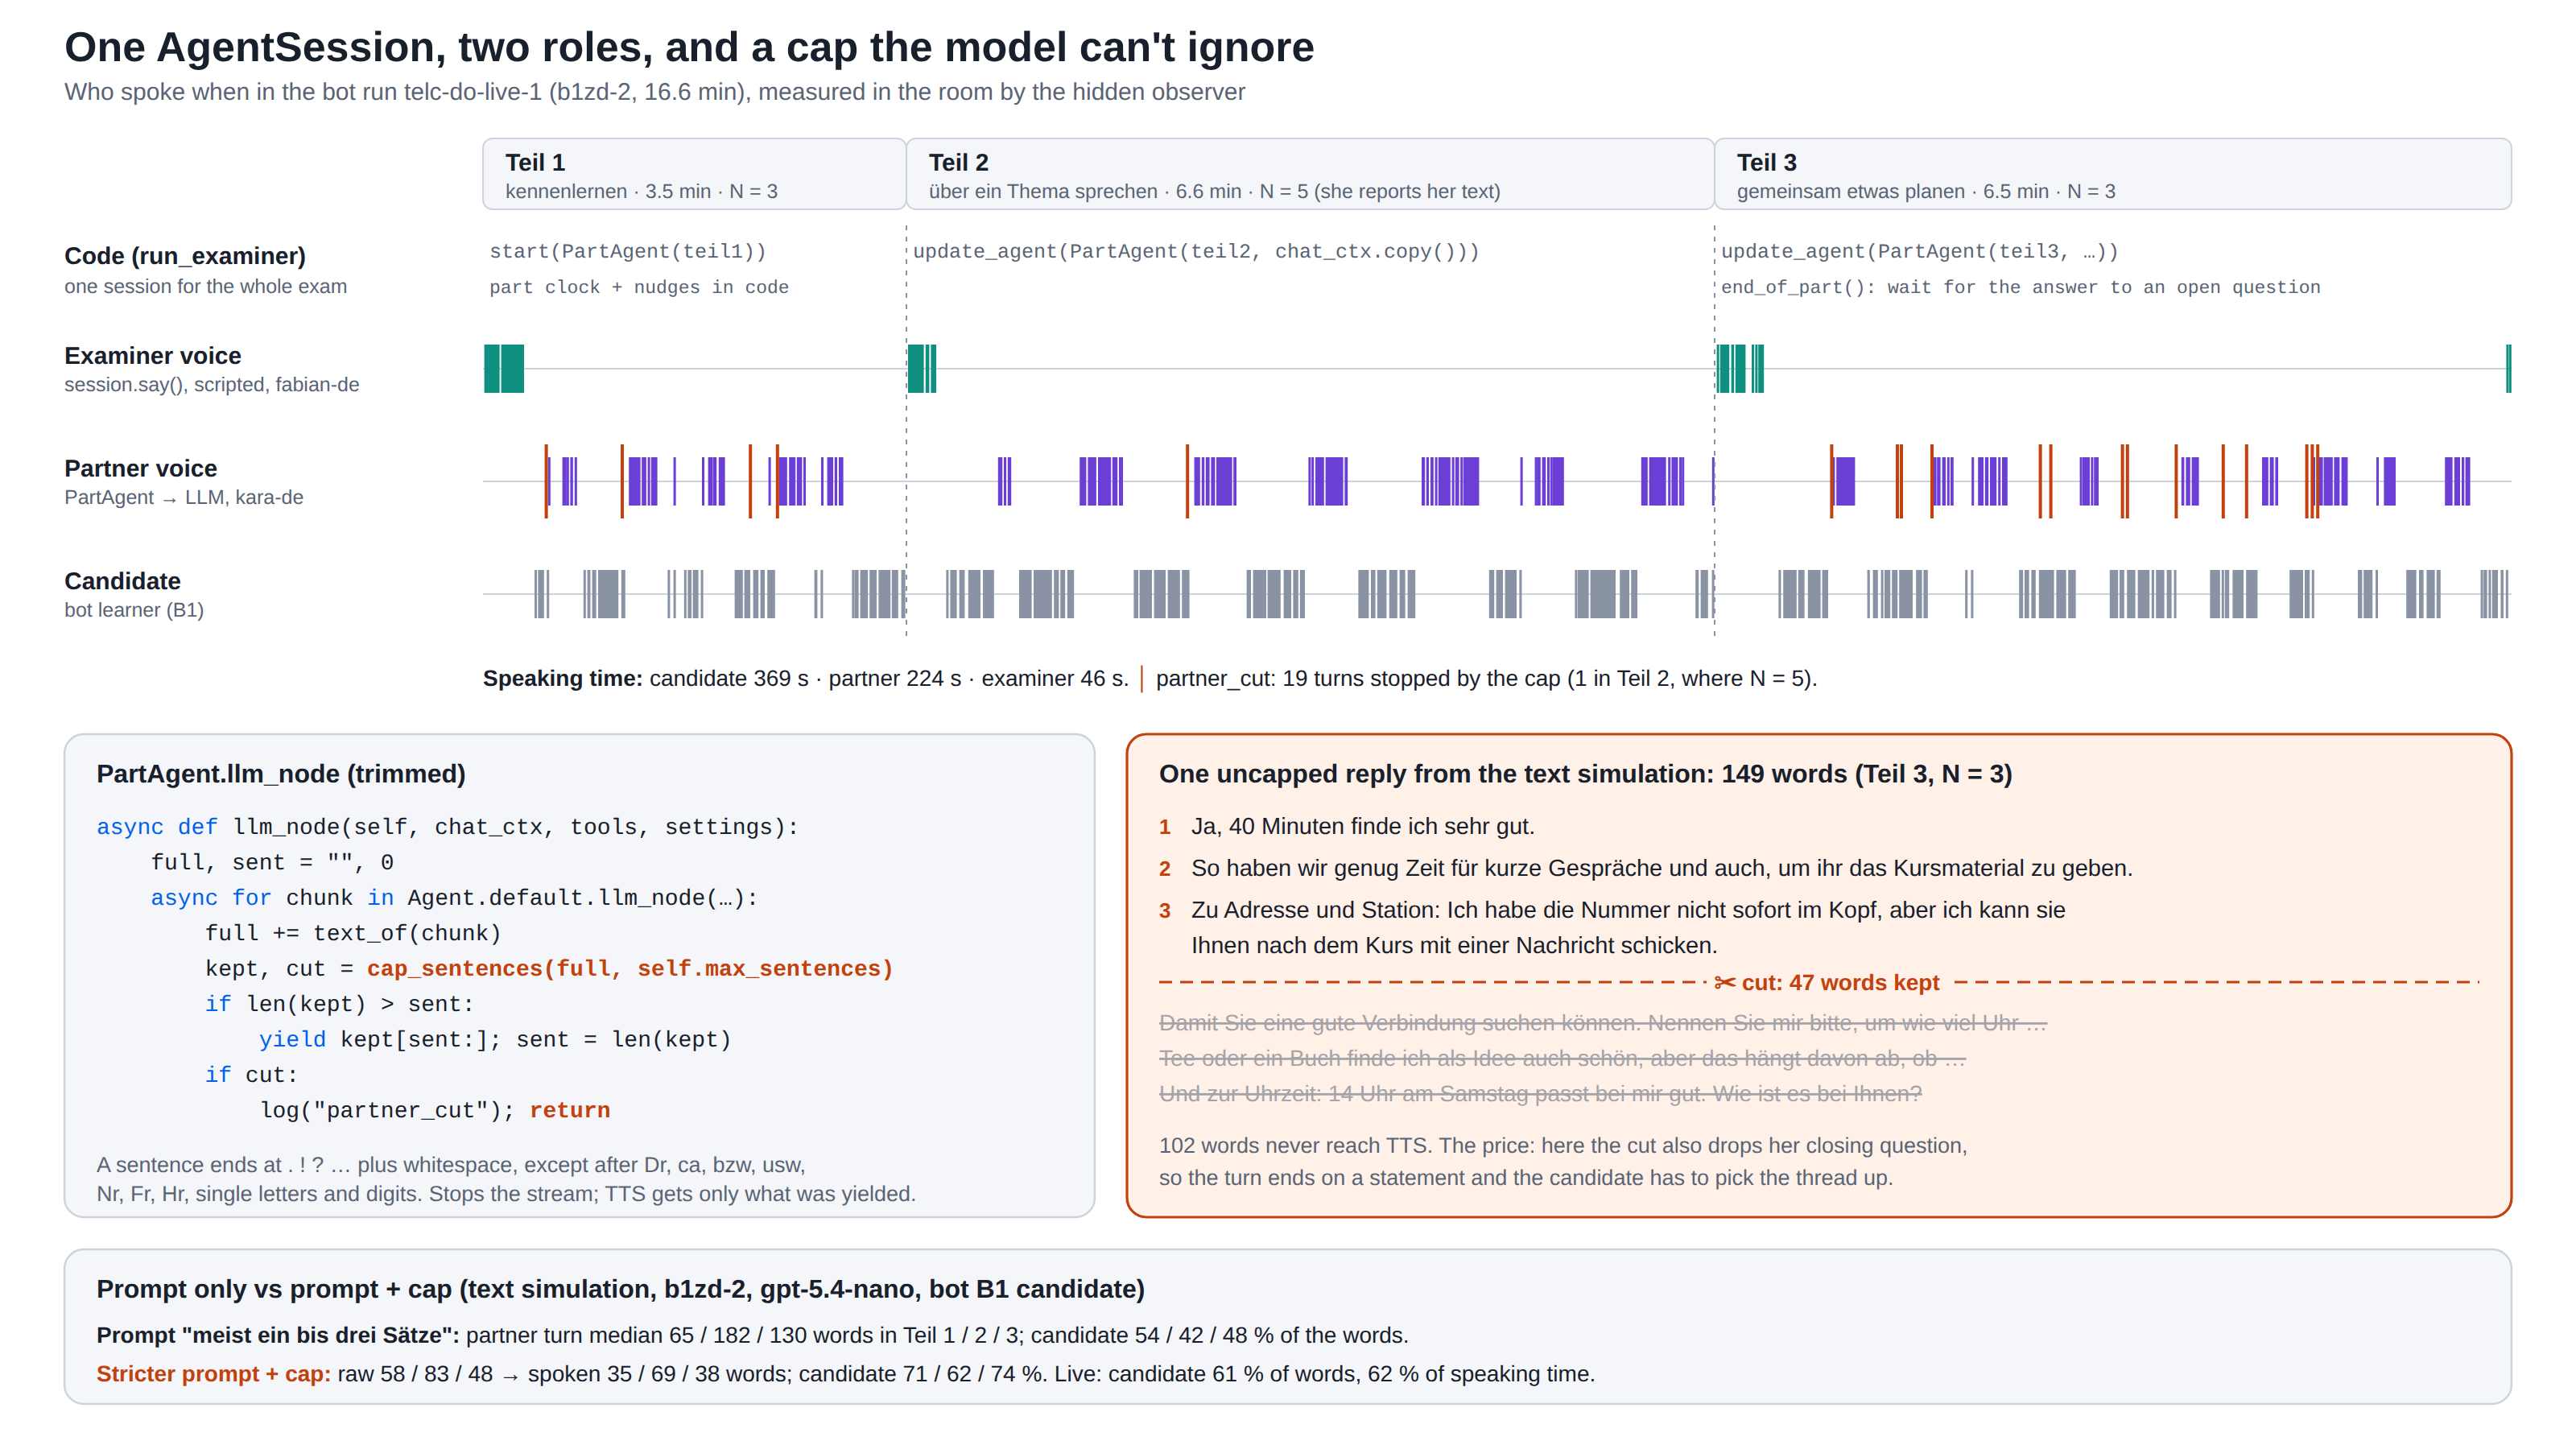
考官的台詞是 telc 練習題裡的固定句子,所以不經過 LLM:session.say(text, audio=<考官 TTS 串流>, add_to_chat_ctx=False, allow_interruptions=False)。每個部分是一個自己的 PartAgent,帶著該部分的任務和搭檔自己的題目卡。換部分時,程式呼叫 session.update_agent(PartAgent(next_part, chat_ctx=current.chat_ctx.copy())),所以 Becker 女士記得你在 Teil 1 說過什麼。時間由程式控制,不靠 prompt:每部分跑滿 telc 規定的分鐘數,然後在下一個停頓結束。
五個問題,以及怎麼解決
1. 每個模型都無視「一到三句」
症狀。 在 A2·B1 的實際測試(telc-smoke-a2b1)裡,搭檔講的字數跟考生一樣多:778 對 782。在一場評的是你的考試裡,等於一半的發言時間沒了。
根本原因。 prompt 寫的是「in kurzen Beiträgen (meist ein bis drei Sätze)」。我讓搭檔用文字對上模擬的 B1 學習者(tests/text_sim_telc.py),試了六個模型。每一個都先把考生剛說的話摘要一遍,再加自己的觀點。gpt-5.4-nano 在 Teil 1、2、3 每輪的中位數是 65、182、130 個字;GPT-4.1 是 54 / 118 / 93;Claude 5.5 Haiku 是 100 / 77 / 69。更嚴格的 prompt(「絕不摘要,最多 3 個短句」)有幫助但不夠:nano 的原始回覆仍是 58 / 83 / 48 字。
解法。 在程式裡截斷。PartAgent 覆寫 llm_node,把串流文字送進 cap_sentences(),只 yield 保留的完整句子,第 N 句之後就 return。N 是 3,B1 的 Teil 2 例外(5,因為她要轉述雜誌短文),A2·B1 的 Teil 3 是 4(她要論述意見)。句子在 . ! ? … 後面接空白處結束,「Dr.」「ca.」「bzw.」、序數等不算。因為只 yield 保留的文字,TTS 根本看不到其他部分。截斷不會增加第一個聲音出來的時間:第一句直接串流過去。
證據。 同一題、同一模型、同一個 bot(commit 300e27e):實際說出的每輪字數降到 35 / 69 / 38,考生的字數占比從 54 / 42 / 48 % 升到 71 / 62 / 74 %。在實測 telc-do-live-1 裡截斷發生 19 次(Teil 2 只有 1 次,因為那裡 N 是 5),考生占 61 % 的字數(1,201 對 762),以及房間裡量到的 62 % 說話時間(369 秒對 224 秒)。
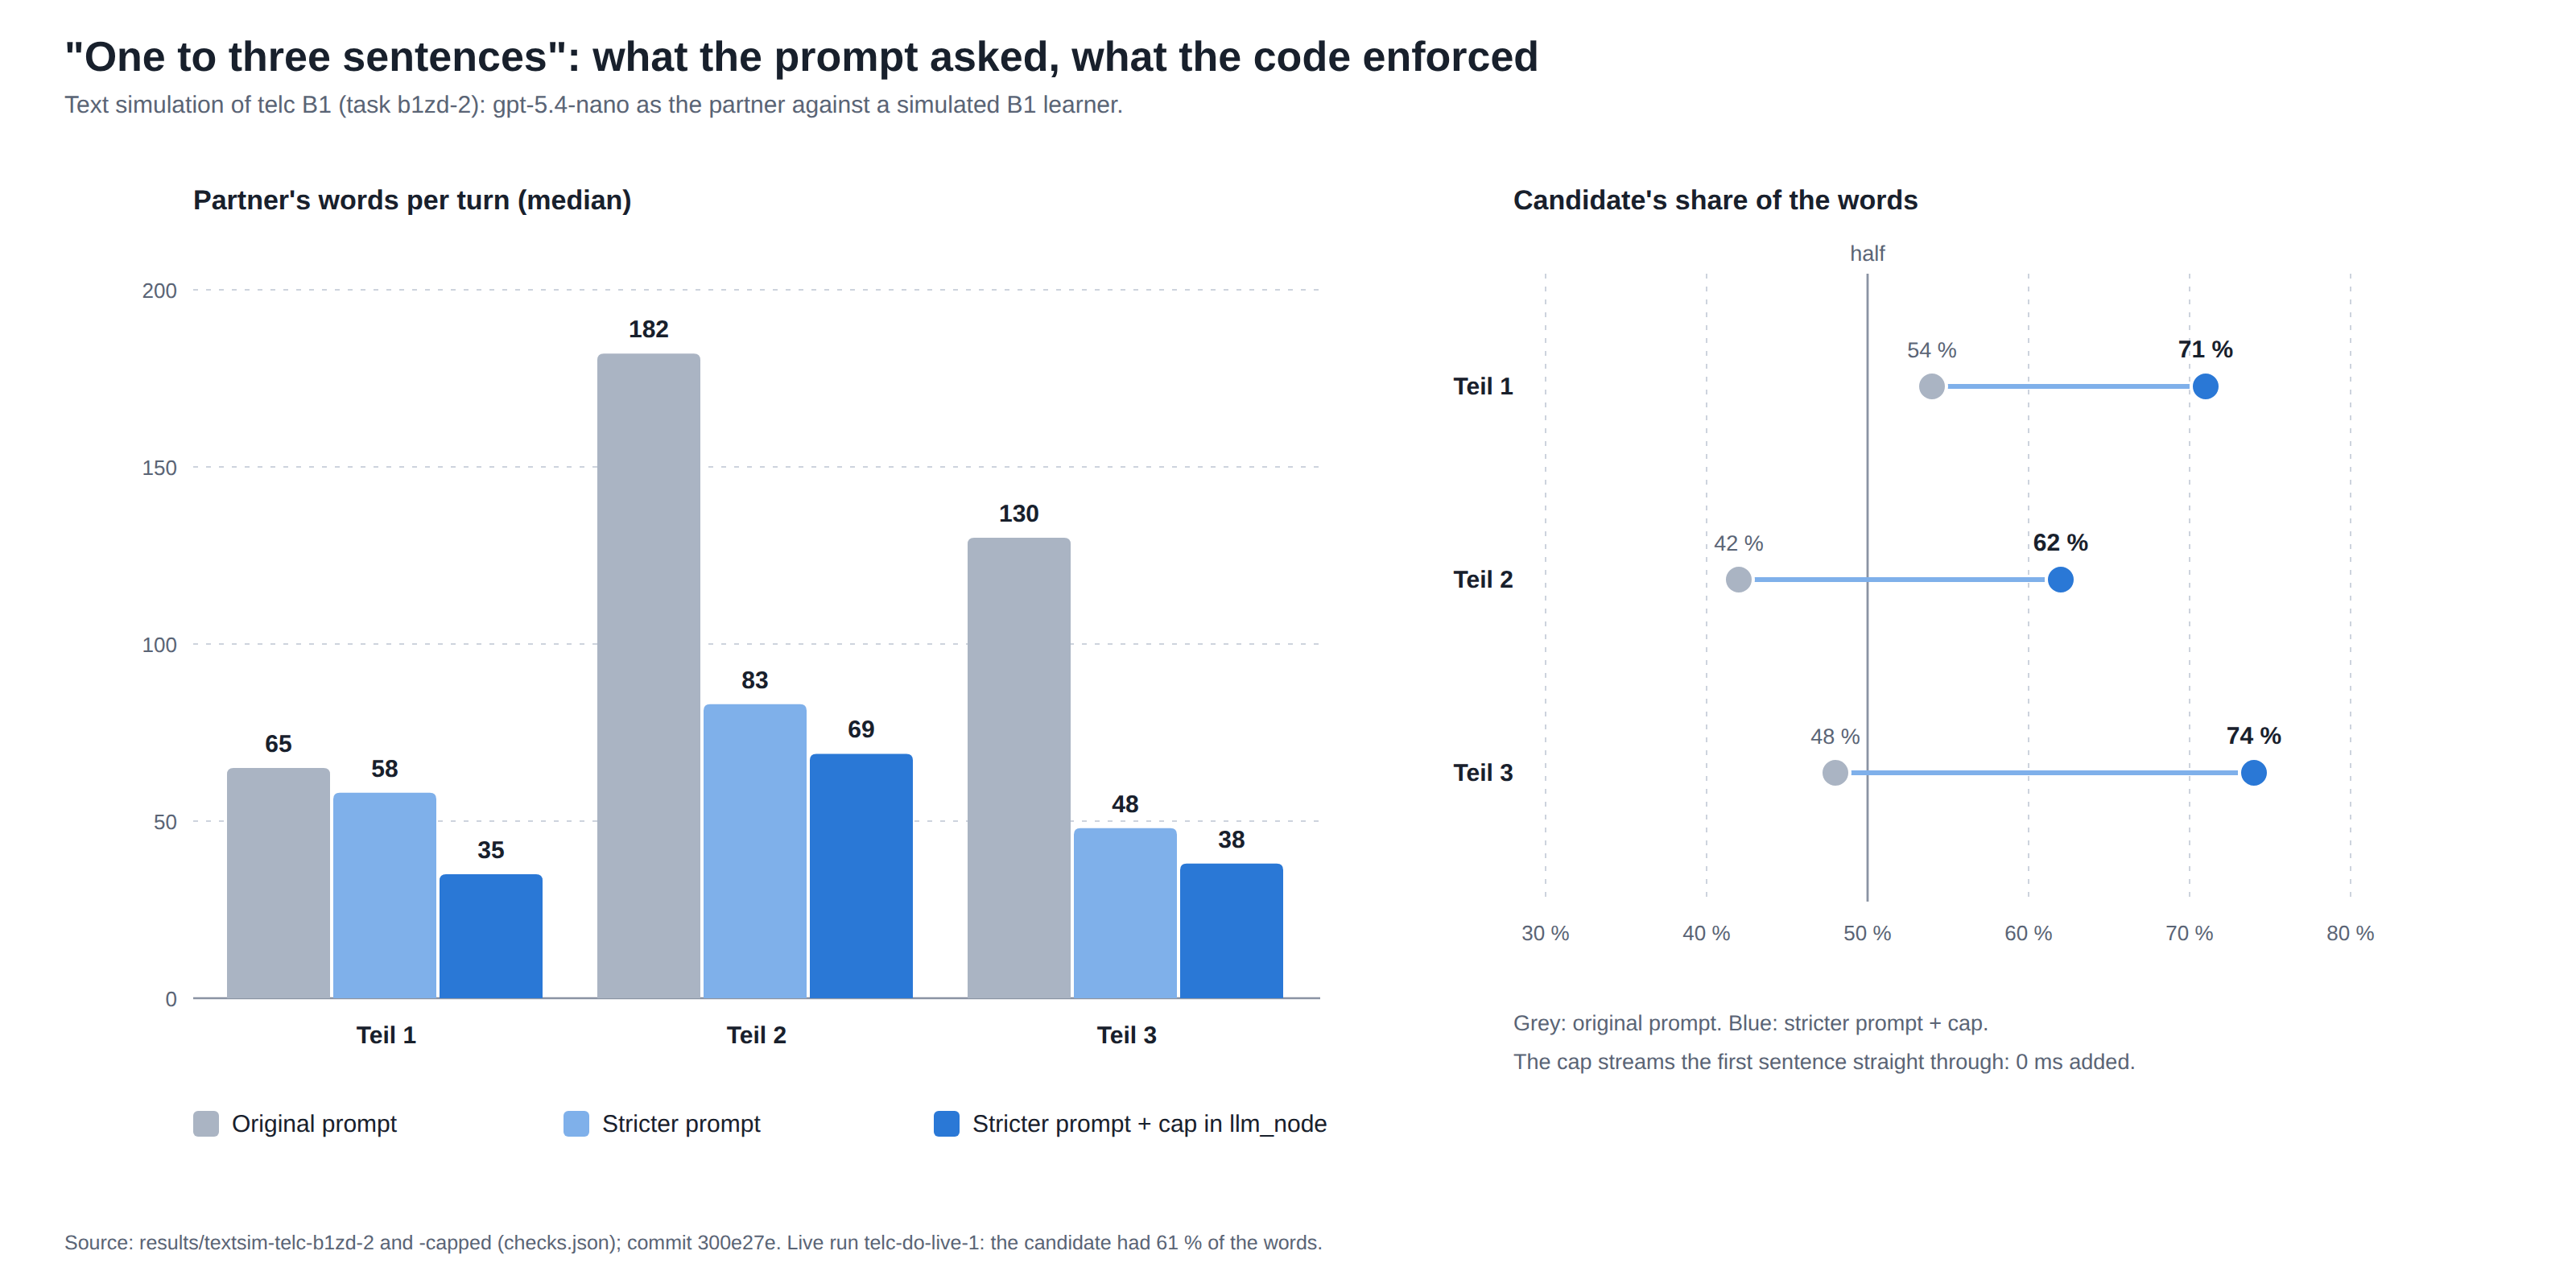 本文的圖,文字都是英文。
截斷有代價,上面「一個 session,兩個角色」那張圖裡也看得到:一則 149 字的回覆只留下 47 字,也把她最後的問句「Wie ist es bei Ihnen?」切掉了。這輪就停在一個陳述句。對考試來說這個取捨是對的,本來就該由考生撐起對話。
2. 只從一邊量沉默的提示
症狀。 telc 說對話卡住時,考官會「小心地」介入。我的第一版讓搭檔在 12 秒沉默後問一個開放式問題。結果在 telc-smoke-1 一場考試裡觸發了 42 次(三部分分別 8、15、19 次),搭檔一直蓋過 bot 說話。
根本原因。 「沉默」是從考生最後一個字開始算,所以搭檔自己說話的時間也被當成考生沉默。記錄裡的 silent_s 從 17 秒一路長到 184 秒:搭檔每說一輪就引發下一次提示。
解法。 任一方開始或停止說話都更新 last_activity,提示需要 user_state != "speaking" 且 agent_state == "listening",每部分最多 2 次(agents/examiner.py 的 should_nudge(),commit dea9405)。
證據。 接下來兩次實測 telc-smoke-a2b1 和 telc-do-live-1,telc_nudge 事件都是零。(寫這篇時我發現 docstring 寫「23 次」,記錄是 42 次,已修正。)
3. 在 localhost 驗證過的時鐘,到 Cloud 上是錯的
症狀。 流暢度分數靠隱形的 observer:它訂閱每一條音訊軌,標記說話的開始和結束。我用測試訊號驗證兩種時間戳方式。在本機 dev server 上,平滑化的 frame 時鐘勝過原始到達時間(絕對標準差 5 ms 對 25 ms)。
根本原因。 到 LiveKit Cloud 上結果反過來:平滑時鐘的標準差 90 ms,到達時間只有 3–5 ms。在真實網路上,傳送間隙和 jitter buffer 的調整打破了平滑化背後「樣本連續」的假設。兩種方式量「間隔」都通過(斜率 0.998–1.001),只有絕對時間的檢查抓得到。
解法。 observer.timestamping: arrival,在 Cloud 上驗證過。我記住的教訓:在儀器實際要跑的地方驗證它。
4. 安靜的預設值:聽不到 agent 的 agent,以及永遠送不到的 attributes
症狀。 有兩件事會失敗卻沒有任何錯誤:一個該聽另一個 agent 的 agent 什麼都聽不到,一方設定的 participant attributes 另一方永遠收不到。
根本原因(讀安裝的 SDK 和發 token 的程式碼才發現,不是從文件)。RoomOptions.participant_kinds 預設只有 SIP 和一般參與者,所以 agent session 會忽略其他 agent。我的 bot 考生就是 agent,考官原本根本聽不到它。另外我發的 token 少了 can_update_own_metadata 權限,set_attributes() 默默什麼都沒做。角色能對上,只是因為程式退回用 participant identity 判斷。
解法。 agents/common.py 裡設 participant_kinds=ALL_KINDS(一般、SIP 和 agent),lk.py 加上那個權限。Losreden 現在靠 attributes 做角色交握,也靠 sprechtest.voice 讓網頁知道該亮哪張說話者卡片。
5. 免費方案決定了架構
症狀。 早期在免費方案上測試時,同時兩通電話在 STT 握手時拿到 HTTP 429,session 以 recoverable=False 關閉,bot 一直等一個不會來的回覆。後來 Cartesia 的聲音在設定到一半時回 HTTP 402。
根本原因。 照我 2026-11-08 讀到的 LiveKit 方案頁,Build 方案的 Inference 允許同時 5 條 STT 和 5 條 TTS 連線、每月 $2.50 用量,所有免費專案共用。Cartesia 的免費額度不到一小時就用完。
解法。 改設定,不改程式:models.stt.via: direct 讓 STT 用我自己的 key 直連 Deepgram EU 端點,聲音也換成同一把 key 的 Deepgram Aura-2。這樣 STT 的考生音訊也留在 EU。turn detector 還在 LiveKit Inference 上。唯一的損失:Aura-2 的德語聲音沒有語速控制,「A2 講慢一點」的設定在換回 Cartesia 前沒有作用。
另外四個小問題
- 答案落到下一部分。 一個部分可能在搭檔剛問完問題時結束,考生的回答就說在下一部分的開場白上,也被算到那裡。
end_of_part()現在會先等開放式問題的回答(最多 20 秒)再換部分(commit2eaafd9)。在telc-do-live-1裡,沒有回答在換部分時被切斷。 - 4 vCPU droplet 的 CPU。 同時跑三通語音通話,load average 衝到 20,量到的延遲跟著飄;py-spy 顯示大部分時間花在每個 frame 的 FFI 搬運,不是我的程式。所以伺服器同一時間只跑一通即時通話(
webapi.capacity(),MAX_CALLS = 1),下一位學習者排隊。worker 的load_threshold設 0.95,因為框架的正式環境預設 0.7 會在機器忙時把考試拒於門外。 - 網頁狀態的競態條件。 考完的考試有時顯示「沒有報告」:狀態 API 先檢查報告、再檢查程序,報告剛好在兩次檢查之間寫好時,就看起來不存在。改成先檢查程序就好了(commit
86dd2e1)。 - 點一下要等 2.8 秒。 我在總覽點「Goethe」,畫面大約三秒沒有反應。總覽和開始練習的頁面每次都會叫一個 Python 小指令拿考試清單,而這個指令只為了一個字串常數就 import 了
sprechtest.agents.common,連帶載入livekit.agents。光這個 import 就要 1.4 秒(它的 inference 模組會載入整套openai型別,還有 telemetry),整個 import 要 2.5 秒。python -X importtime跑一次就找到了。常數搬到一個什麼都不 import 的模組,livekit.api只在發 token 的指令裡才載入,網頁把考試清單記住、YAML 改了才重讀,站內連結點下去會顯示進度條。一次呼叫從 2.8 秒變 0.6 秒,staging 上從總覽點到開始練習頁面,從約 3 秒變 0.1 秒(commit5e42857、7ba21b7)。教訓:每個請求都會呼叫外部程式的話,要量的是 import,不只是工作本身。
延遲預算
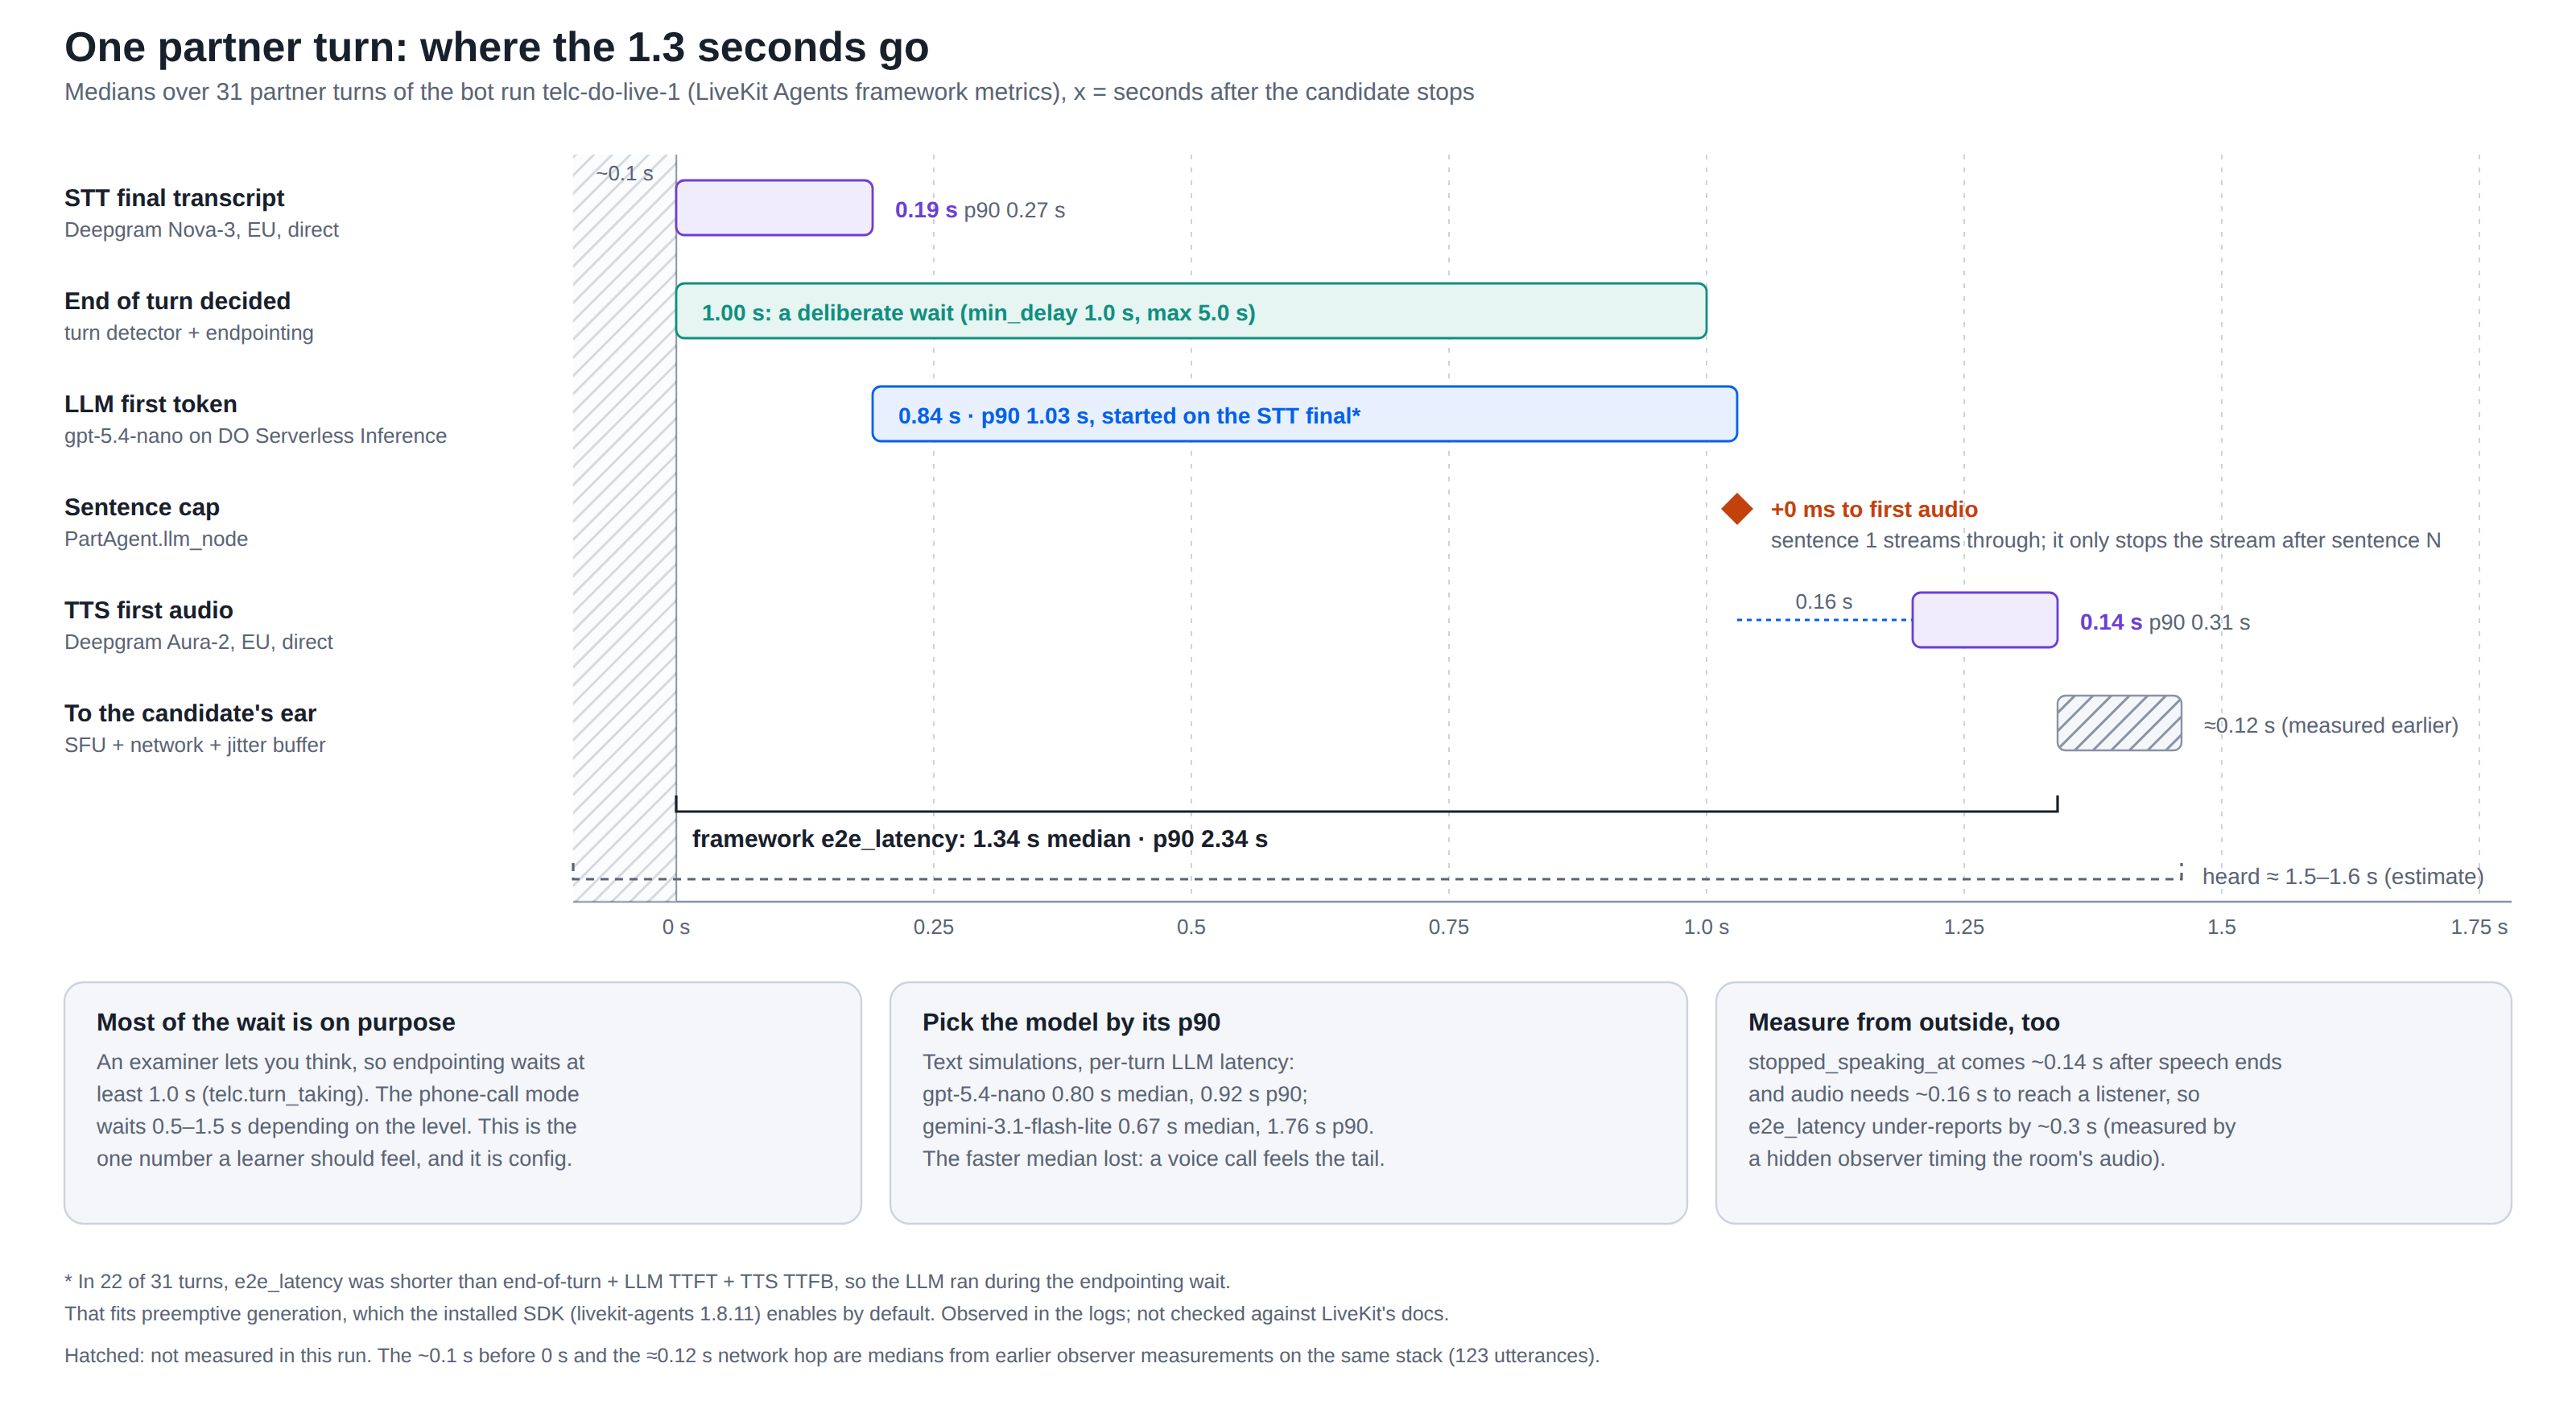
在 telc-do-live-1 的 31 輪搭檔發言裡,框架的 e2e_latency 中位數 1.34 秒(p90 2.34 秒)。最大的一塊是刻意的一秒等待:考官會讓你想,所以這一場的 endpointing 至少等 1.0 秒(telc.turn_taking)。現在改成 2.0 秒,原因見第二篇。LLM 第一個 token 中位數 0.84 秒(p90 1.03 秒),TTS 第一段音訊 0.14 秒(p90 0.31 秒)。
這些加起來不是 1.34 秒,記錄說明了原因:31 輪裡有 22 輪,e2e_latency 比「判定換人 + TTFT + TTFB」還短。LLM 在 STT 最終結果出來時就開始了,跟 endpointing 的等待重疊。這符合 preemptive generation,安裝的 SDK 預設開啟。這是我從記錄觀察到的,沒有對照文件確認。
框架的數字少算了兩段。之前用同一個 observer 量到,stopped_speaking_at 比實際說完晚約 0.14 秒,聲音到聽者耳朵還要再約 0.16 秒。所以考生實際聽到的大約是 1.5–1.6 秒。這是估計,不是這次實測量到的。
取捨
| 決定 | 我的選擇 | 代價 | 證據 |
|---|---|---|---|
| 一個 session 或兩個 agent | 一個 AgentSession,考官用 say() 搭自己的 TTS | 一個參與者兩個聲音;瀏覽器要靠 sprechtest.voice 才知道誰在說 | agents/examiner.py |
| 用 prompt 還是程式控制長度 | prompt 加上 llm_node 截斷 | 有時切掉她最後的問句 | 考生占比 54/42/48 % → 71/62/74 % |
| 直連 Deepgram 或 LiveKit Inference | 直連 EU 端點,自己的 key | 分開計費;Inference STT 標價 $0.0048/分,直連 $0.0077 | config/default.yaml、上面的 429 和 402 |
| 選 LLM | 看 p90,不看中位數 | Gemini 3.1 Flash Lite 中位數比較快 | nano 0.80 秒 / p90 0.92 秒;Gemini 0.67 秒 / p90 1.76 秒(文字模擬) |
| 相信框架指標嗎 | 旁邊再放一個隱形 observer | 每場多一個參與者和程序 | e2e_latency 少算約 0.3 秒(observer 量測) |
| 隱私或發音 | 不存音訊;Aussprache 用 STT 字詞信心值 | 只是代理指標:麥克風、噪音、人名也會拉低 | observer.store_audio: false;報告的注意事項 |
| 每場一個 CLI 或 worker pool | 每場一個 CLI 加 worker | 啟動慢,每台 droplet 同時只跑一通 | web/src/lib/server/py.ts、webapi.capacity() |
| 評審評一次或三次 | 平行三次,取中位等級 | 評審 token 三倍 | 三次評分最多只在一個標準上差一級 |
| 用 Opus 還是便宜的評審 | Opus 5.5,等老師評過再說 | 約占整場成本的 40 % | 六場存檔重評:Sonnet 5.5 平均低 7 分,Haiku 5.5 低 10 分;Opus 自己重評有 91 % 等級相同 |
| 她要等多久 | 固定 min_delay 2.0 秒、false_interruption_timeout 3.0 秒 | 她晚約 1 秒回答 | 學習者的停頓被打斷 13 %,舊設定 50 %(第二篇) |
練一次要多少錢
從 11 月 10 日起,每場都會寫一份 usage.json:STT 秒數、每個聲音的 TTS 字元數、從框架 metrics 事件拿到的 LLM 和評審 token,再乘上 2026-11-09 查的牌價(config/prices.yaml:Deepgram Nova-3 每分鐘 $0.0077、Aura-2 每千字元 $0.030、nano 每百萬 token $0.20 / $1.25、Opus 5.5 $4 / $20、LiveKit 每參與者每分鐘 $0.0005、換人偵測每千次 $0.50)。下面兩場是 bot 考試。bot 考生有自己的 STT、TTS 和 LLM,所以我把它那一份扣掉,算出真人考一場的成本。
| 練習 | STT | TTS | LLM | 評審(3 次) | LiveKit | 換人偵測 | 合計 |
|---|---|---|---|---|---|---|---|
| telc B1 Teil 1(3.5 分) | 0.027 | 0.040 | 0.004 | 0.176 | 0.005 | 0.006 | $0.26 |
| telc B1 整場(16 分) | 0.124 | 0.217 | 0.038 | 0.277 | 0.024 | 0.023 | $0.70 |
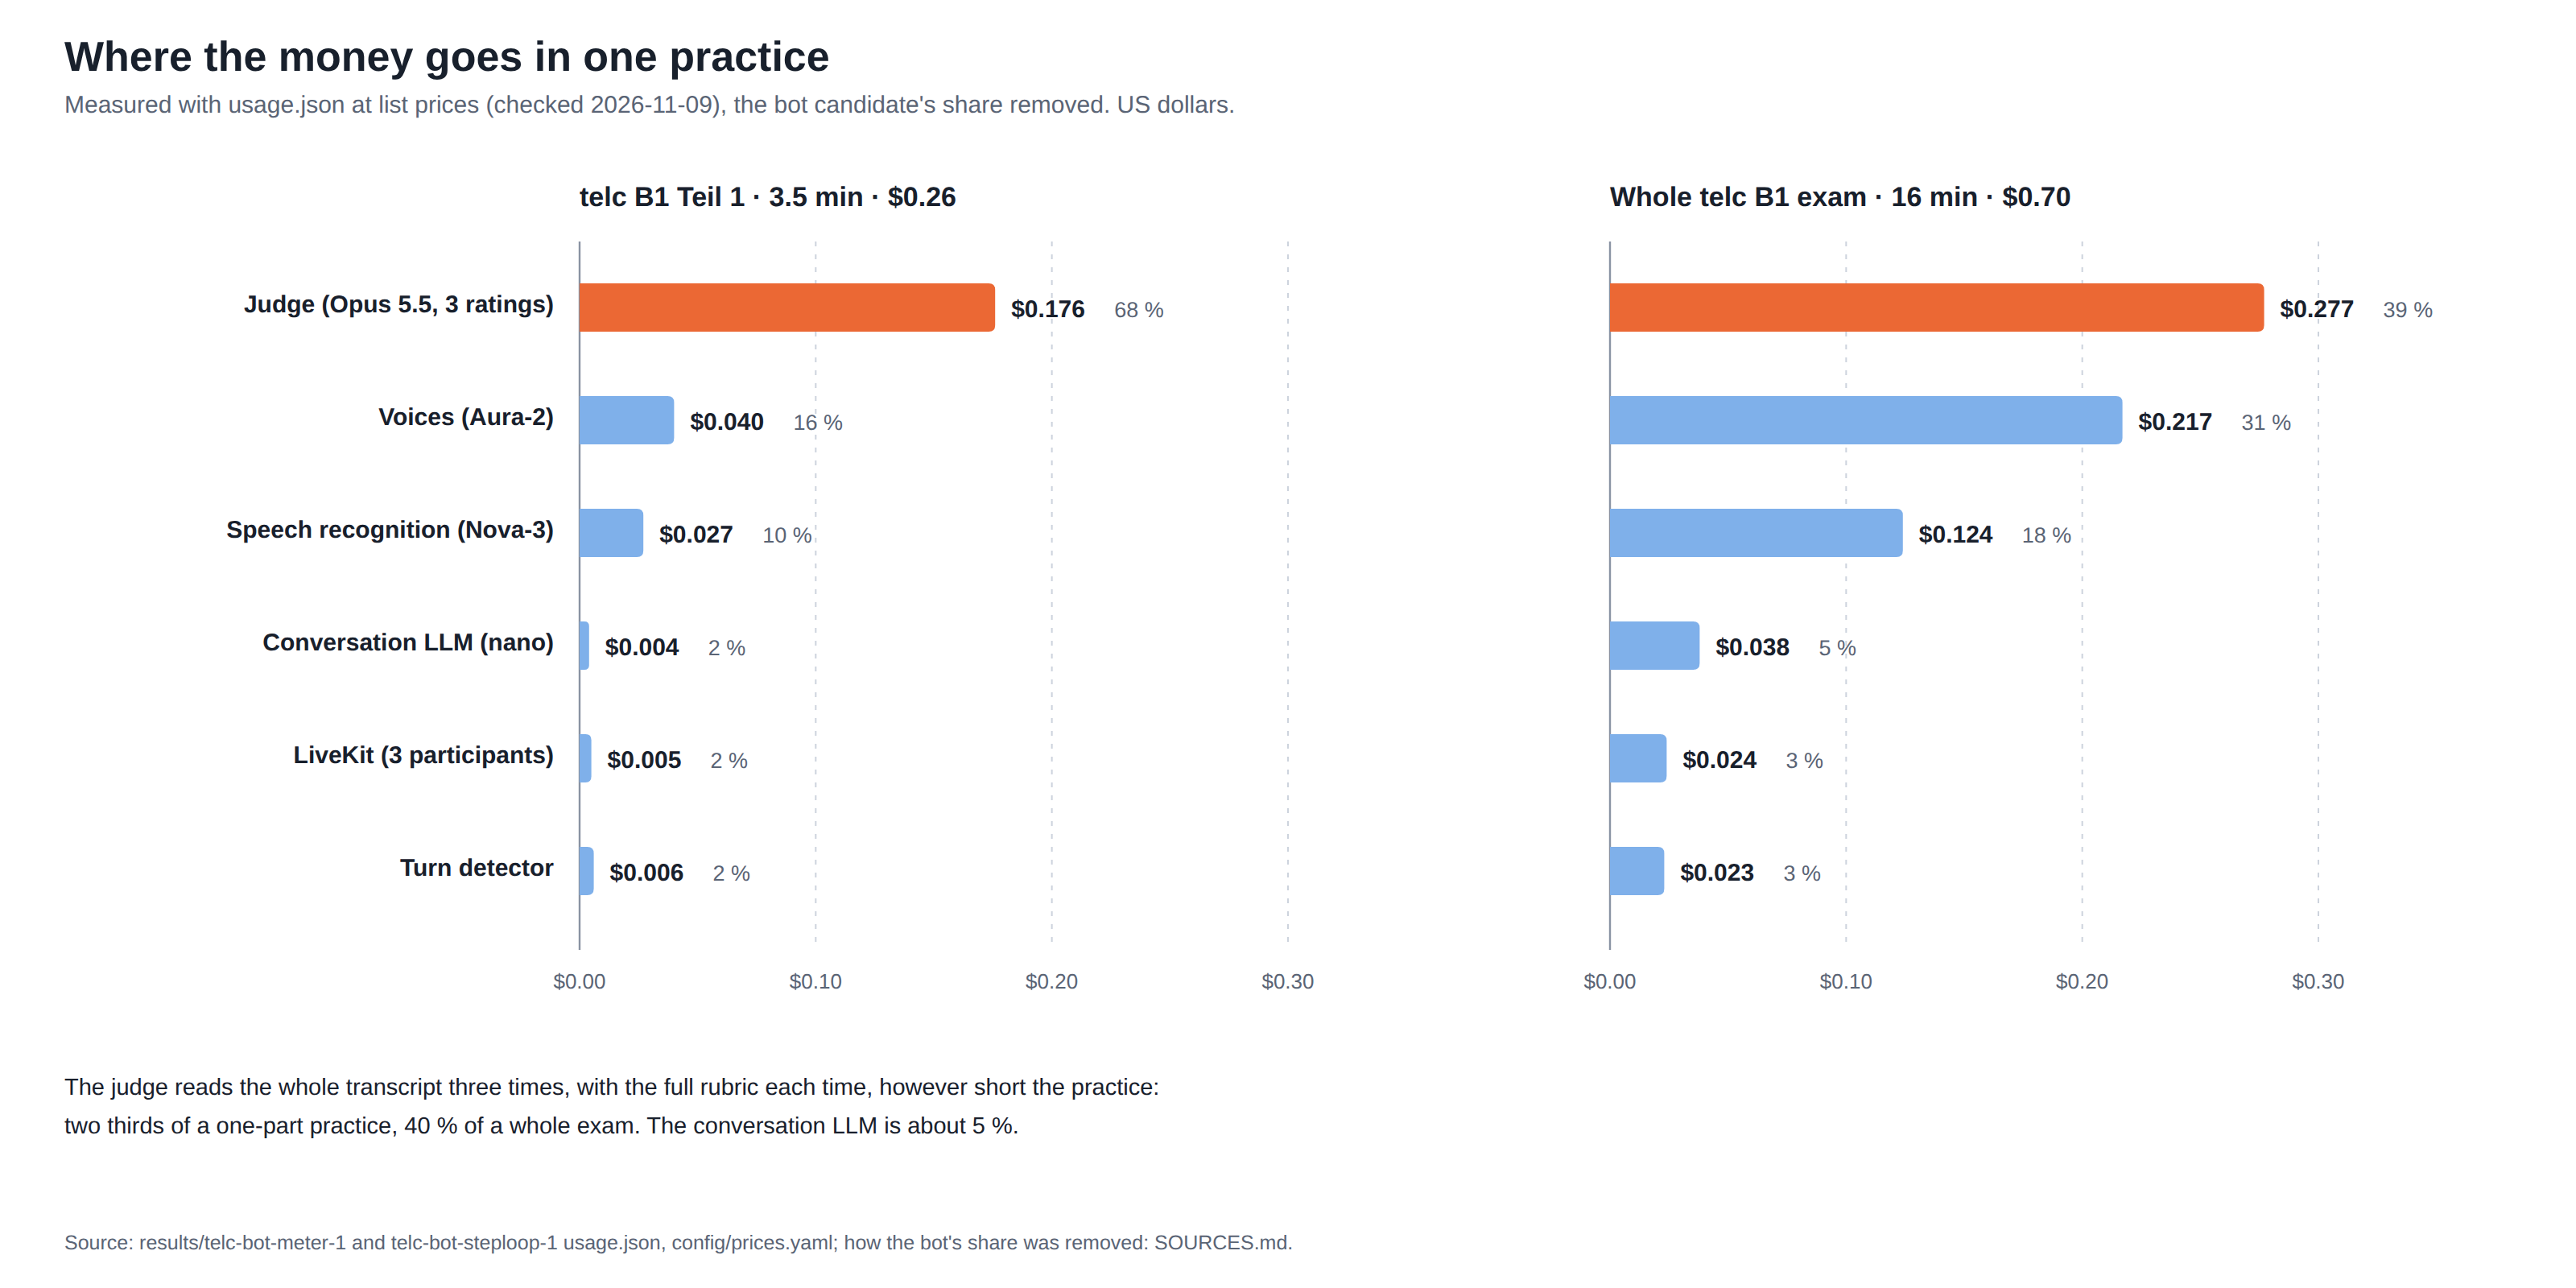
一整場模擬考大約 NT$22。開始計量之前我估的是 $0.49,估錯的是兩項:評審(實測 $0.28,當初估 $0.13)和聲音(7,244 個字元,比我假設的多約 45 %)。評審是最大的一項,占整場的 40 %、單一部分練習的三分之二,因為不管練習多短,三次評分每次都要帶上完整的評分標準和指示。對話用的 LLM 只占約 5 %。20 分鐘的準備時間不花錢,因為那時沒有開通話。
最直接的槓桿是換便宜的評審,我用今天的程式重評了六場存檔試過(docs/judge-comparison.md,花了 $2.2)。Opus 5.5 自己重評一次,91 % 的等級和之前相同,所以下面的差距是模型造成的,不是隨機誤差。Sonnet 5.5 有 58 % 的等級和 Opus 相同,平均低 7 分(最多 16 分);Haiku 5.5 是 53 %,平均低 10 分(最多 20 分)。兩個都比較嚴,但沒有離譜。換過去會改變學習者看到的分數,不只是帳單,所以在老師評過足夠的逐字稿、能判斷哪個評審比較接近老師之前,先繼續用 Opus。
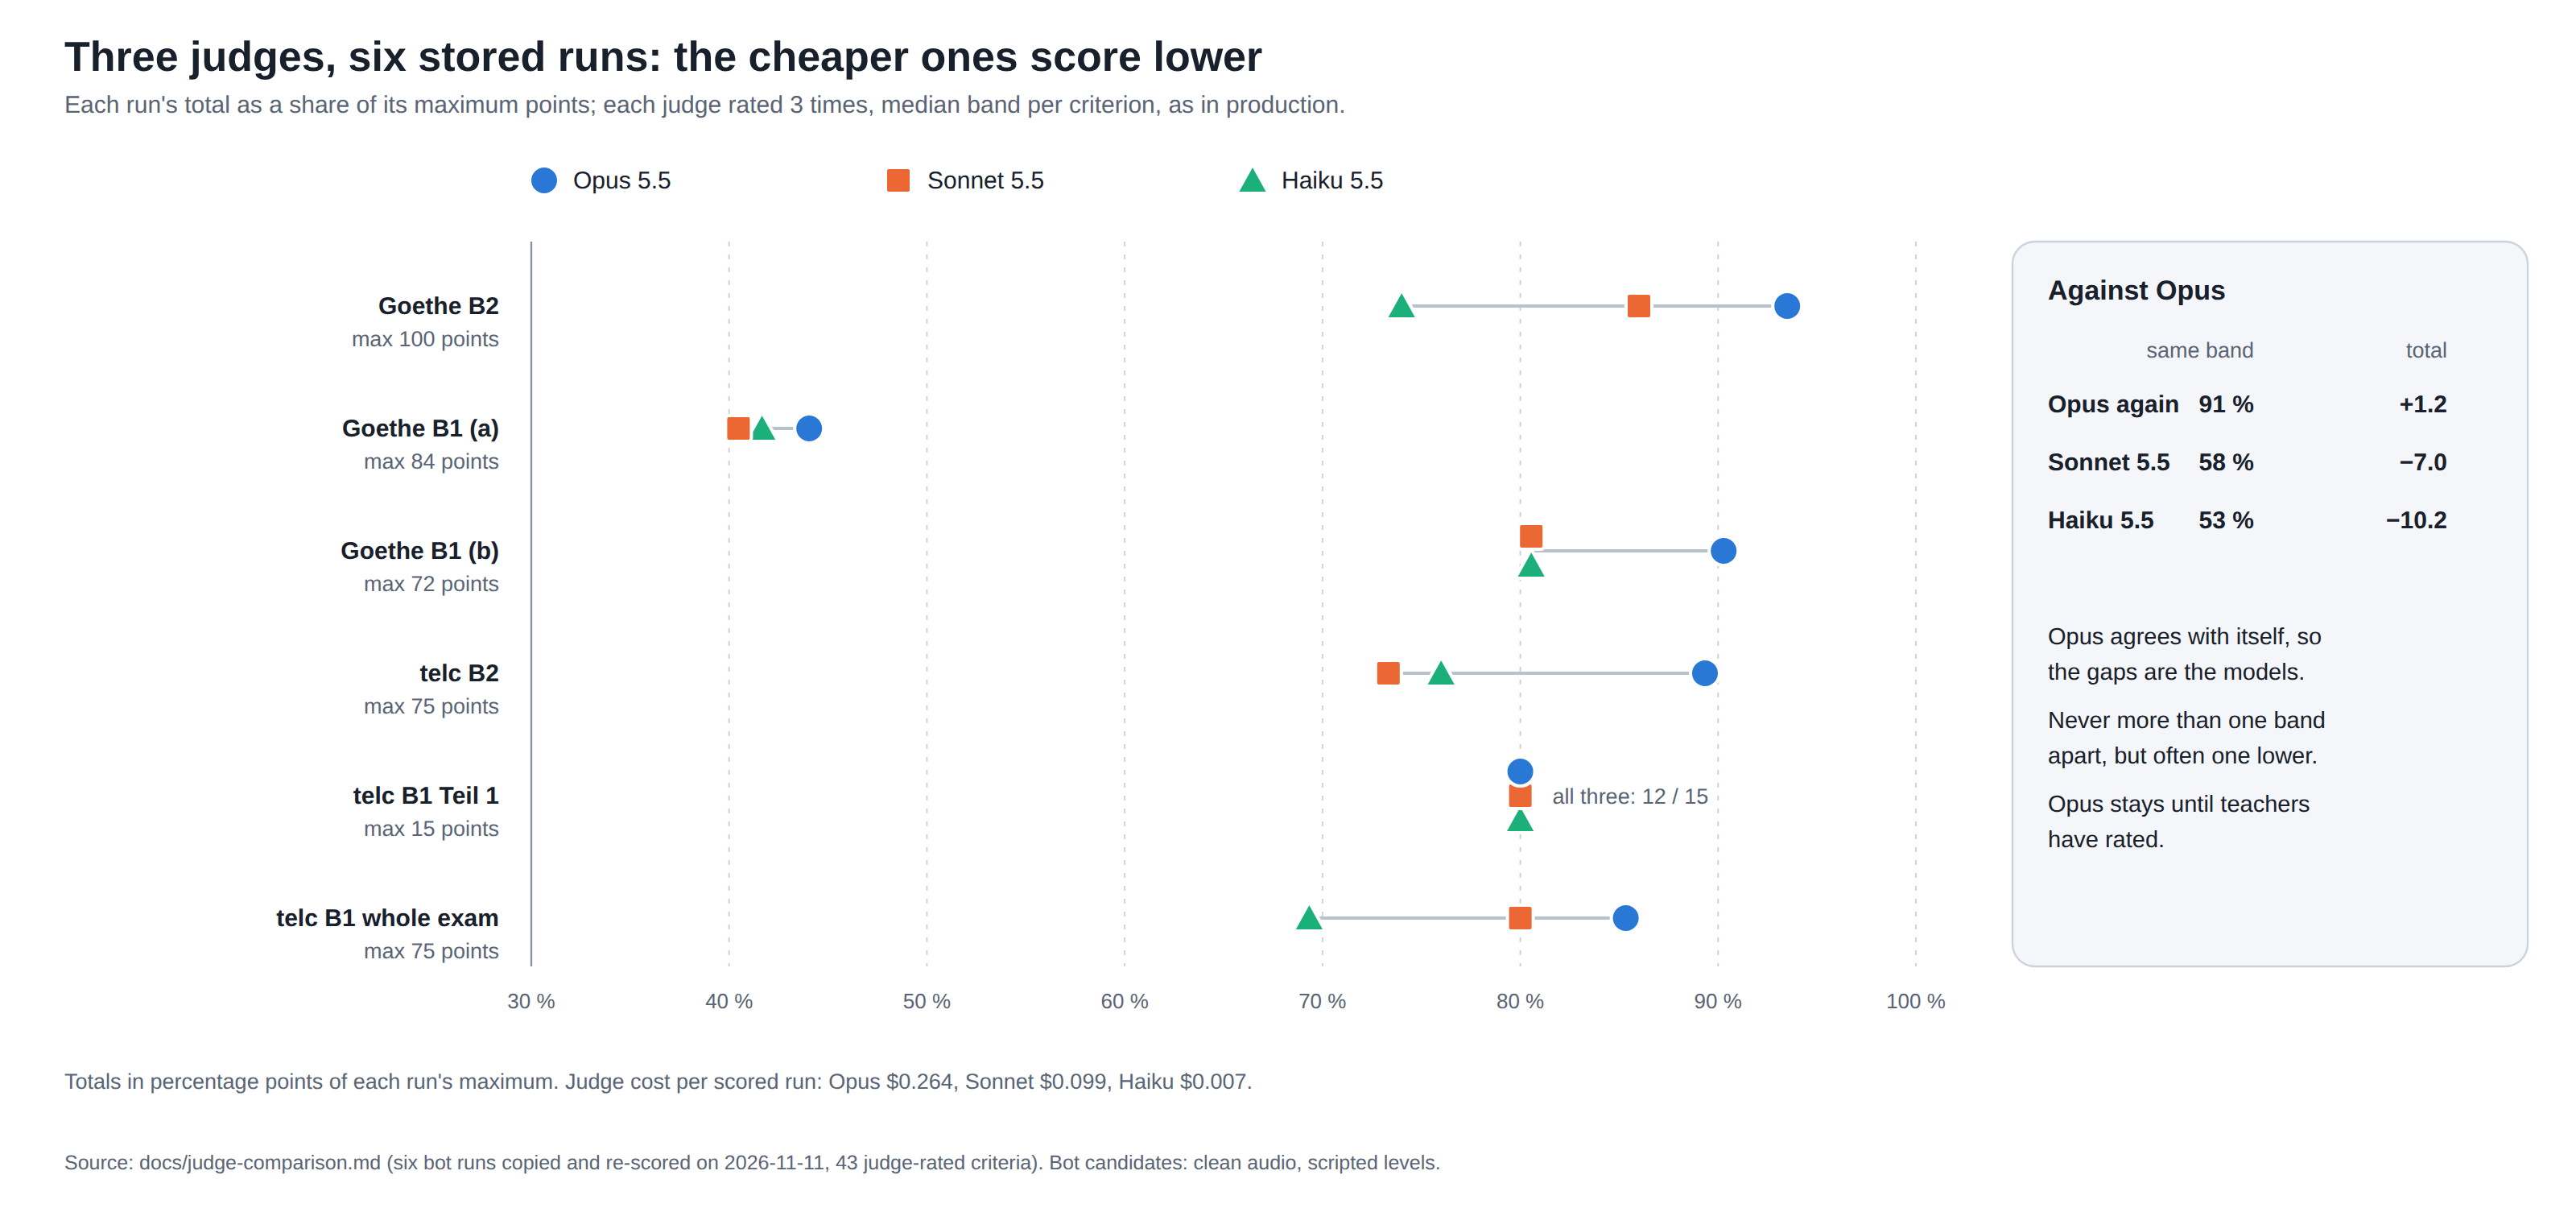
不影響分數的槓桿優先:快取評審重複的 prompt、前兩次不一致才評第三次,以及考官固定台詞預先合成好音檔。
不只 telc B1
同一套引擎現在跑不只一種考試。每種格式是一個 YAML 檔,裡面有步驟流程:對話、獨白(你報告時 AI 保持安靜),以及考伴自己做報告。telc B1、A2·B1、B2,以及 Goethe-Zertifikat B1 和 B2 都跑在上面;Goethe 的題目是我們照官方格式自己寫的,因為官方題目不能拿來商用。周邊還有:邀請制試用(點數,以及上面那張表背後的計量)、用學習者的語言(繁中、Deutsch 或 English)寫回饋而糾錯維持德文、在 /try 免註冊試三分鐘 telc B1 Teil 1,以及讓老師先逐項評匿名化逐字稿、送出後才看到 AI 分數的評分頁。目前還沒有人評過,所以上面的評審比較是和 Opus 比,不是和老師比。
接下來
- 老師評分:每種格式約 30 份評過的逐字稿之後,才會說分數「和老師差在一個等級以內」。
- 不改變分數的省錢方法:上面提到的評審和聲音兩個槓桿。
- 用 worker pool 取代每場一個 CLI: 長駐的 worker 跑在自己的 droplet 上,網頁伺服器透過 LiveKit API dispatch。這樣就沒有一次一通的限制。
- TestDaF:照計時錄音作答,不是對話,是成本最低的格式。
我想向 LiveKit 提的需求
這些來自我實際卡住好幾個小時的地方,不是願望清單。
- 預設值丟掉東西時說一聲。 agent session 因為
participant_kinds忽略某個參與者時記一行 log;沒有can_update_own_metadata卻呼叫set_attributes()時給個警告。這兩個都讓我在沒有任何錯誤可循的情況下除錯。 - 聽者端的延遲。
e2e_latency從stopped_speaking_at開始算,到聲音離開 agent 為止。一個寫進文件的偏移量,或在訂閱端量測的選項,可以讓大家不用各自打造 observer。 - 在 metrics 標出 preemptive 回覆。 每輪加個旗標,延遲數字就不用靠猜來對帳。
- 把發言長度預算變成正式選項。 我試過的每個模型都無視「三句」。agent 上的
max_sentences,或一份寫進文件的llm_node範例,就能讓這件事成為預設路徑,而不是覆寫。 - 更清楚的免費方案錯誤。 STT 握手的 429 讓 session 以無法恢復的方式關閉。一個寫明方案限制的錯誤訊息,可以省下很多困惑。
- 輕量的 import 路徑。
import livekit.agents大約要 1.4 秒,大部分花在程式根本用不到的模組上。inference 和 telemetry 模組如果延遲載入,同一套程式碼裡的小工具指令就能很快啟動。
做這一個練習工具,讓我學到的即時語音比任何教學都多。模型是最容易的部分,時間都花在換人時機、沉默和預設值上。如果你也在 LiveKit 上開發,想交流心得,很歡迎找我。