利益揭露:我是 DigitalOcean 的 Solutions Architect,所以文中提到 DigitalOcean 產品時,是「業內人的觀點」而非中立第三方——這些地方我都會明確標示,其餘分析則盡量保持廠商中立。以下皆為個人觀點。
學語言的人會停頓。句子講到一半找字時會停,一句文法上已經完整的話說完也常常停:「Ich komme aus Taiwan.[2 秒]Also, ich wohne jetzt in Köln.」對一個用流利語料訓練的換人偵測模型來說,第二種停頓聽起來就像「輪到我了」。
我的口說模擬考 Losreden(第一篇寫它怎麼建在 LiveKit Agents 上)有一位 AI 考伴。在考試裡,她能做的最不公平的事,就是在考生思考的停頓中間搶話。所以我搭了一個實驗台,量她多常這樣做,以及哪些設定能讓她不要這樣做。
實驗打了 58 通電話,花了 $8.09,也抓出我自己測試工具裡的兩個 bug。最意外的結果是:LLM 的速度本身就是換人策略的一部分。用舊設定時,午夜後考伴打斷學習者停頓的次數是午夜前的兩倍,原因是 LLM 供應商在深夜比較快。
以下都來自 livekit-agents 1.8.11、一位照腳本說話的學習者,以及 telc B1 Teil 1(互相認識)。完整的實驗紀錄(每一通都在)是 repo 裡的 docs/turnlab-buildlog.md。
TL;DR
- 實驗: 八組 LiveKit 換人設定,40 通電話,對象是一個每次都停在同樣地方的腳本化合成 B1 學習者,由房間裡的隱形 observer 從外部量測。整個實驗共 58 通電話、花了 8.09 美元。
- 把
false_interruption_timeout調到 3.0 秒是最明確的收穫: 學習者說「Äh, ähm.」之後,搭檔在 2.0 秒時 15 次裡有 15 次又開口蓋過去,3.0 秒時 15 次裡 3 次。 - adaptive barge-in 對學習者比較差, 而 dynamic endpointing 在一場考試的單一部分內沒有幫助:它起點低、學得慢,而且每次
update_agent()就重置。 - LLM 的速度是策略的一部分。 當
min_delay低於 LLM 的首 token 時間,舊設定在午夜前切進 29 % 的完整句子後停頓、午夜後是 64 %,原因是服務商變快了。 - 我選的設定: fixed 2.0 / 5.0 秒、timeout 3.0 秒、VAD barge-in。切進所有停頓的比例從 50 % 降到 13 %,代價是回覆晚約 1 秒。
一開始拿到的建議
LiveKit 社群論壇上有一串討論非母語者換人偵測的文章,給了四個建議:
- 用 dynamic endpointing(
mode: dynamic, min_delay: 0.5, max_delay: 5.0),讓 agent 學這個人停多久。 - 把
false_interruption_timeout(預設 2.0 秒)拉到大約學習者停頓的長度。 - 用 VAD 打斷,而不是 adaptive interruption 模型。後者大概是用會隨口附和(backchannel)的母語者訓練的,學習者很少這樣。
- 以說話者真正停下來的時間點為準來量,不要用框架自己判定的「說完了」。
四點聽起來都對,我大可直接打開就算完成。但我先讀了安裝的原始碼,因為讀程式碼不花錢。
原始碼說了、論壇沒說的事
還沒打第一通電話,就有五件事改變了實驗設計:
- adaptive interruption 模型其實從來沒開過。 沒設定打斷模式、worker 又跑在 production 模式時,
AgentActivity._resolve_interruption_detection不會回傳偵測器。每場考試的 job 都會記一行adaptive interruption is disabled by default in production mode。所以我的考試本來就是 VAD 打斷,該測的反而是「把 adaptive 打開」。 - dynamic endpointing 每次交接都會忘記。
AgentActivity.start會重建一個 endpointing 物件,而session.update_agent()會開一個新的 activity。我的考試每個部分都換一次 agent(telc B1 三次,Goethe B1 七個步驟),所以它在 Teil 1 學到的東西到 Teil 2 就沒了。我加了延續機制:換之前讀出學到的值,再用session.update_options(endpointing_opts={"min_delay": learned})傳下去。 - dynamic 的起點比我原本的還低。 它從設定值往上學
min_delay(指數移動平均,alpha 0.9,每次停頓移動 10 %),而且不會低於設定值。我原本固定 1.0 秒,建議的下限是 0.5 秒。在看過幾次停頓之前,它反而更快搶話。 min_delay管的是哪種停頓。 有換人偵測模型時,模型覺得句子沒說完就用max_delay(5.0 秒),覺得可能說完了才用min_delay。所以句子中間的停頓主要是模型的事;min_delay管的是句子已經完整之後的停頓,正好是學習者停下來想的地方。- 什麼算「假打斷」。 使用者一開口,agent 會先暫停自己的聲音。如果接著出現有字的最終辨識結果,就算真的被打斷。只有沒有字的打斷(例如 STT 丟掉的一聲「Ähm」)才會走到
false_interruption_timeout,時間到了 agent 就把剛才那句話接著講下去,蓋過還在找字的學習者。還有一個細節:interruption.min_duration是 0.5 秒,太短的「Ähm」根本不算打斷。我第一次合成的「Ähm.」只有 0.30 秒,所以腳本改用比較長的填充詞。
實驗台:每次都停在同樣地方的學習者
LLM 扮演的 bot 每次停頓都不一樣,所以我改寫了一位照腳本說話的學習者,telc B1 Teil 1 共 16 輪。每段話只用 Deepgram Aura-2 合成一次並快取,頭尾的靜音切掉。這樣每個條件聽到的都是同樣的聲音、同樣的停頓:
- 9 個在完整句子之後、7 個在句子中間、3 個在填充詞之後,每個 1.2–3.0 秒;
- 4 輪在考伴說話時插話(barge-in),然後停頓。
學習者是一般的房間參與者,像麥克風一樣穩定送出 10 毫秒的音框。它從考伴的 lk.agent.state 判斷她說完了沒,0.7 秒後才反應。
從外面量。 數字來自房間裡一個隱形的 observer:兩條音軌各跑一個能量 VAD,每個音框在抵達時蓋時間戳。我在 Cloud 上驗證 observer 時發現,在 LiveKit Cloud 上,平滑過的音框時鐘誤差 90 毫秒,抵達時間戳只差 3–5 毫秒。如果考伴的聲音在停頓開始之後、學習者下一段說完之前被聽到,這個停頓就算被打斷。插話的情況,我量她還繼續講了多久,以及她有沒有在同一輪裡又開口(蓋過學習者),並和框架自己的 agent_false_interruption(resumed=true) 事件對照。
每個新設定都寫進設定檔,預設值維持舊行為。有一個測試檢查預設值產生的選項和以前完全一樣。
我自己工具裡的兩個 bug
第一次試跑(舊設定,$0.16)給了一個很大聲的數字:完整句子後的 9 次停頓裡,考伴搶了 8 次。這會是很好的標題,但那是我的 bug。
把時間軸印出來、不只看統計表,就發現學習者的時鐘有兩種:和 observer 的落差不是 0.17 秒就是約 0.8 秒。原因不在網路,每段話結尾的落差一直是穩定的 0.14 ± 0.01 秒。問題在 Aura-2:有些音檔開頭先有一個 10 毫秒、−42 dBFS 的雜音,接著約 0.75 秒的靜音,而我的修剪會保留第一個有聲音的窗口之後的所有東西。所以有些「精確」的停頓其實比腳本長了 0.75 秒。修剪改成從第一段 50 毫秒的語音開始之後,舊設定在完整句子後只搶了 9 次裡的 1 次,不是 8 次。
第二個 bug:插話來得太晚。學習者是用考伴聲音的能量判斷「她在說話」,但她句子之間能量會掉下來,所以 4 次插話有 2 次落在空檔或她說完之後。現在改用她的 lk.agent.state,整段回覆期間都是「speaking」。
試跑的另一個教訓:每個條件只跑一次什麼都說明不了。同一組設定跑兩次,所有停頓裡被打斷的比例分別是 21 % 和 32 %。所以之後每個條件跑 5 次、交錯進行(A1 B1 C1 … A2 B2 …),每次約 5 分鐘、$0.14。
八個條件,40 通電話
每個條件:完整句子後的停頓 45 個、句子中間 35 個、填充詞後 15 個、插話 20 次。間隔是學習者最後一個字到她開口的時間。
| 設定 | 完整句子後被打斷 | 句子中間 | 插話後蓋過學習者 | 間隔中位數 / p90 | |
|---|---|---|---|---|---|
| A | 舊設定:固定 1.0 / 5.0 秒,VAD 打斷,timeout 2.0 秒 | 29 % | 0 % | 75 % | 2.95 / 6.75 秒 |
| B | dynamic 0.5 / 5.0 秒 | 33 % | 3 % | 75 % | 2.81 / 6.72 秒 |
| C | B + timeout 3.0 秒 | 36 % | 9 % | 15 % | 2.85 / 7.01 秒 |
| D | C + adaptive 打斷 | 29 % | 14 % | 90 % | 2.80 / 5.93 秒 |
| E | 固定 2.0 / 5.0 秒 | 22 % | 9 % | 70 % | 3.95 / 5.85 秒 |
| F | A,關掉 resume | 80 % | 20 % | 0 % | 2.19 / 5.82 秒 |
| G | A + timeout 3.0 秒 | 64 %(見下文) | 9 % | 25 % | 2.63 / 5.92 秒 |
| H | 固定 2.0 / 5.0 秒 + timeout 3.0 秒 | 22 % | 3 % | 30 % | 3.67 / 6.65 秒 |
逐點對照論壇的建議:
-
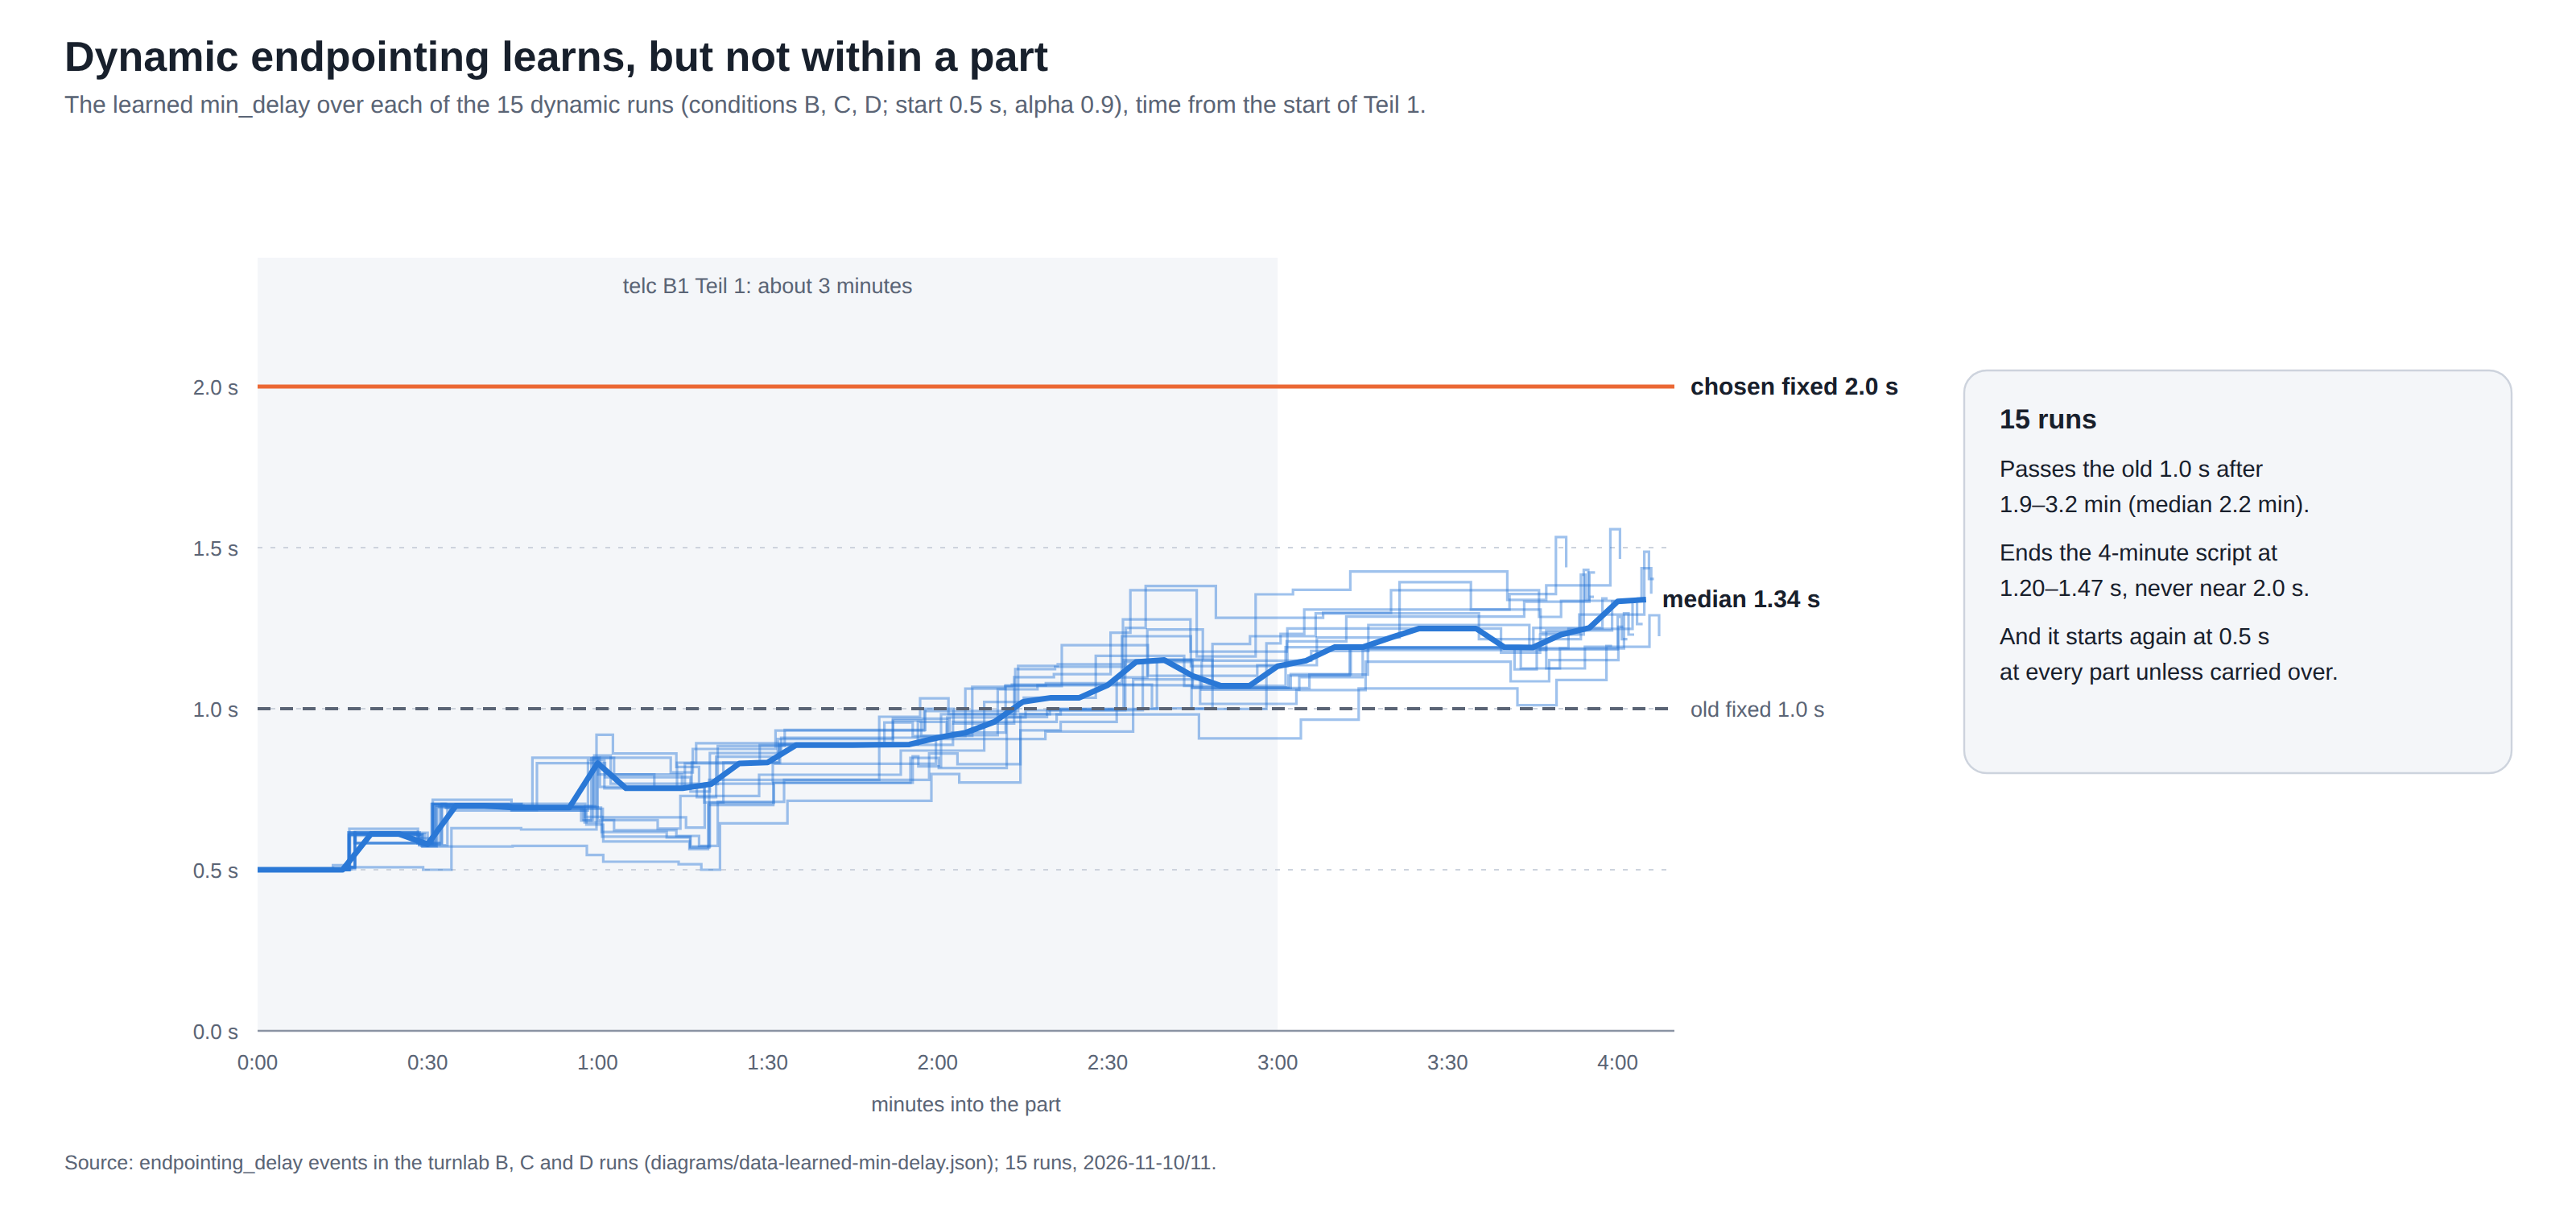
在考試的一個部分裡,dynamic endpointing 沒有幫助。 B 對 A 是 33 % 對 29 %,在每次之間的自然變動範圍內。它從 0.5 秒開始,約兩分鐘(1.9–3.2 分鐘)才越過舊的固定 1.0 秒,四分鐘的腳本結束時停在 1.2–1.5 秒,離 2.0 秒還很遠。telc B1 的 Teil 1 大約 3 分鐘。延續機制解決的是每個部分重來的問題,解決不了學得慢。
-
把
false_interruption_timeout拉到 3.0 秒,效果最明顯。 學習者說了「Äh, ähm.」然後找字 2.4–3.0 秒,在 2.0 秒的設定下,15 次裡考伴 15 次都把剛才那句話重新講一次蓋過去;3.0 秒時只有 3 次(B 對 C)。論壇說對了。 -
adaptive 打斷對學習者比較差,和論壇猜的一樣(D 對 C)。它把「Äh, ähm.」和「Ja, aber …」判成附和,所以她繼續講 0.9 秒(VAD 是 0.6 秒),20 次插話有 18 次她又接著講。這些都沒走假打斷的計時器:判成附和就直接繼續講,所以 timeout 拉長也沒用。
-
在房間裡量,答案就不一樣。 條件 F 關掉
resume_false_interruption,完整句子後被打斷的比例從 29 % 變成 80 %。F 裡的她並沒有比較快。resume 開著時,一段在學習者繼續說之前剛好確定的回覆,會在第一個音框之前就被暫停,學習者的字一到就被丟掉,所以學習者根本聽不到。resume 關掉就不會暫停,她會先講出 0.1–0.6 秒,才被學習者的聲音打斷。框架自己的interrupted計數兩種情況看起來一樣,只有房間裡的聽者聽得出差別。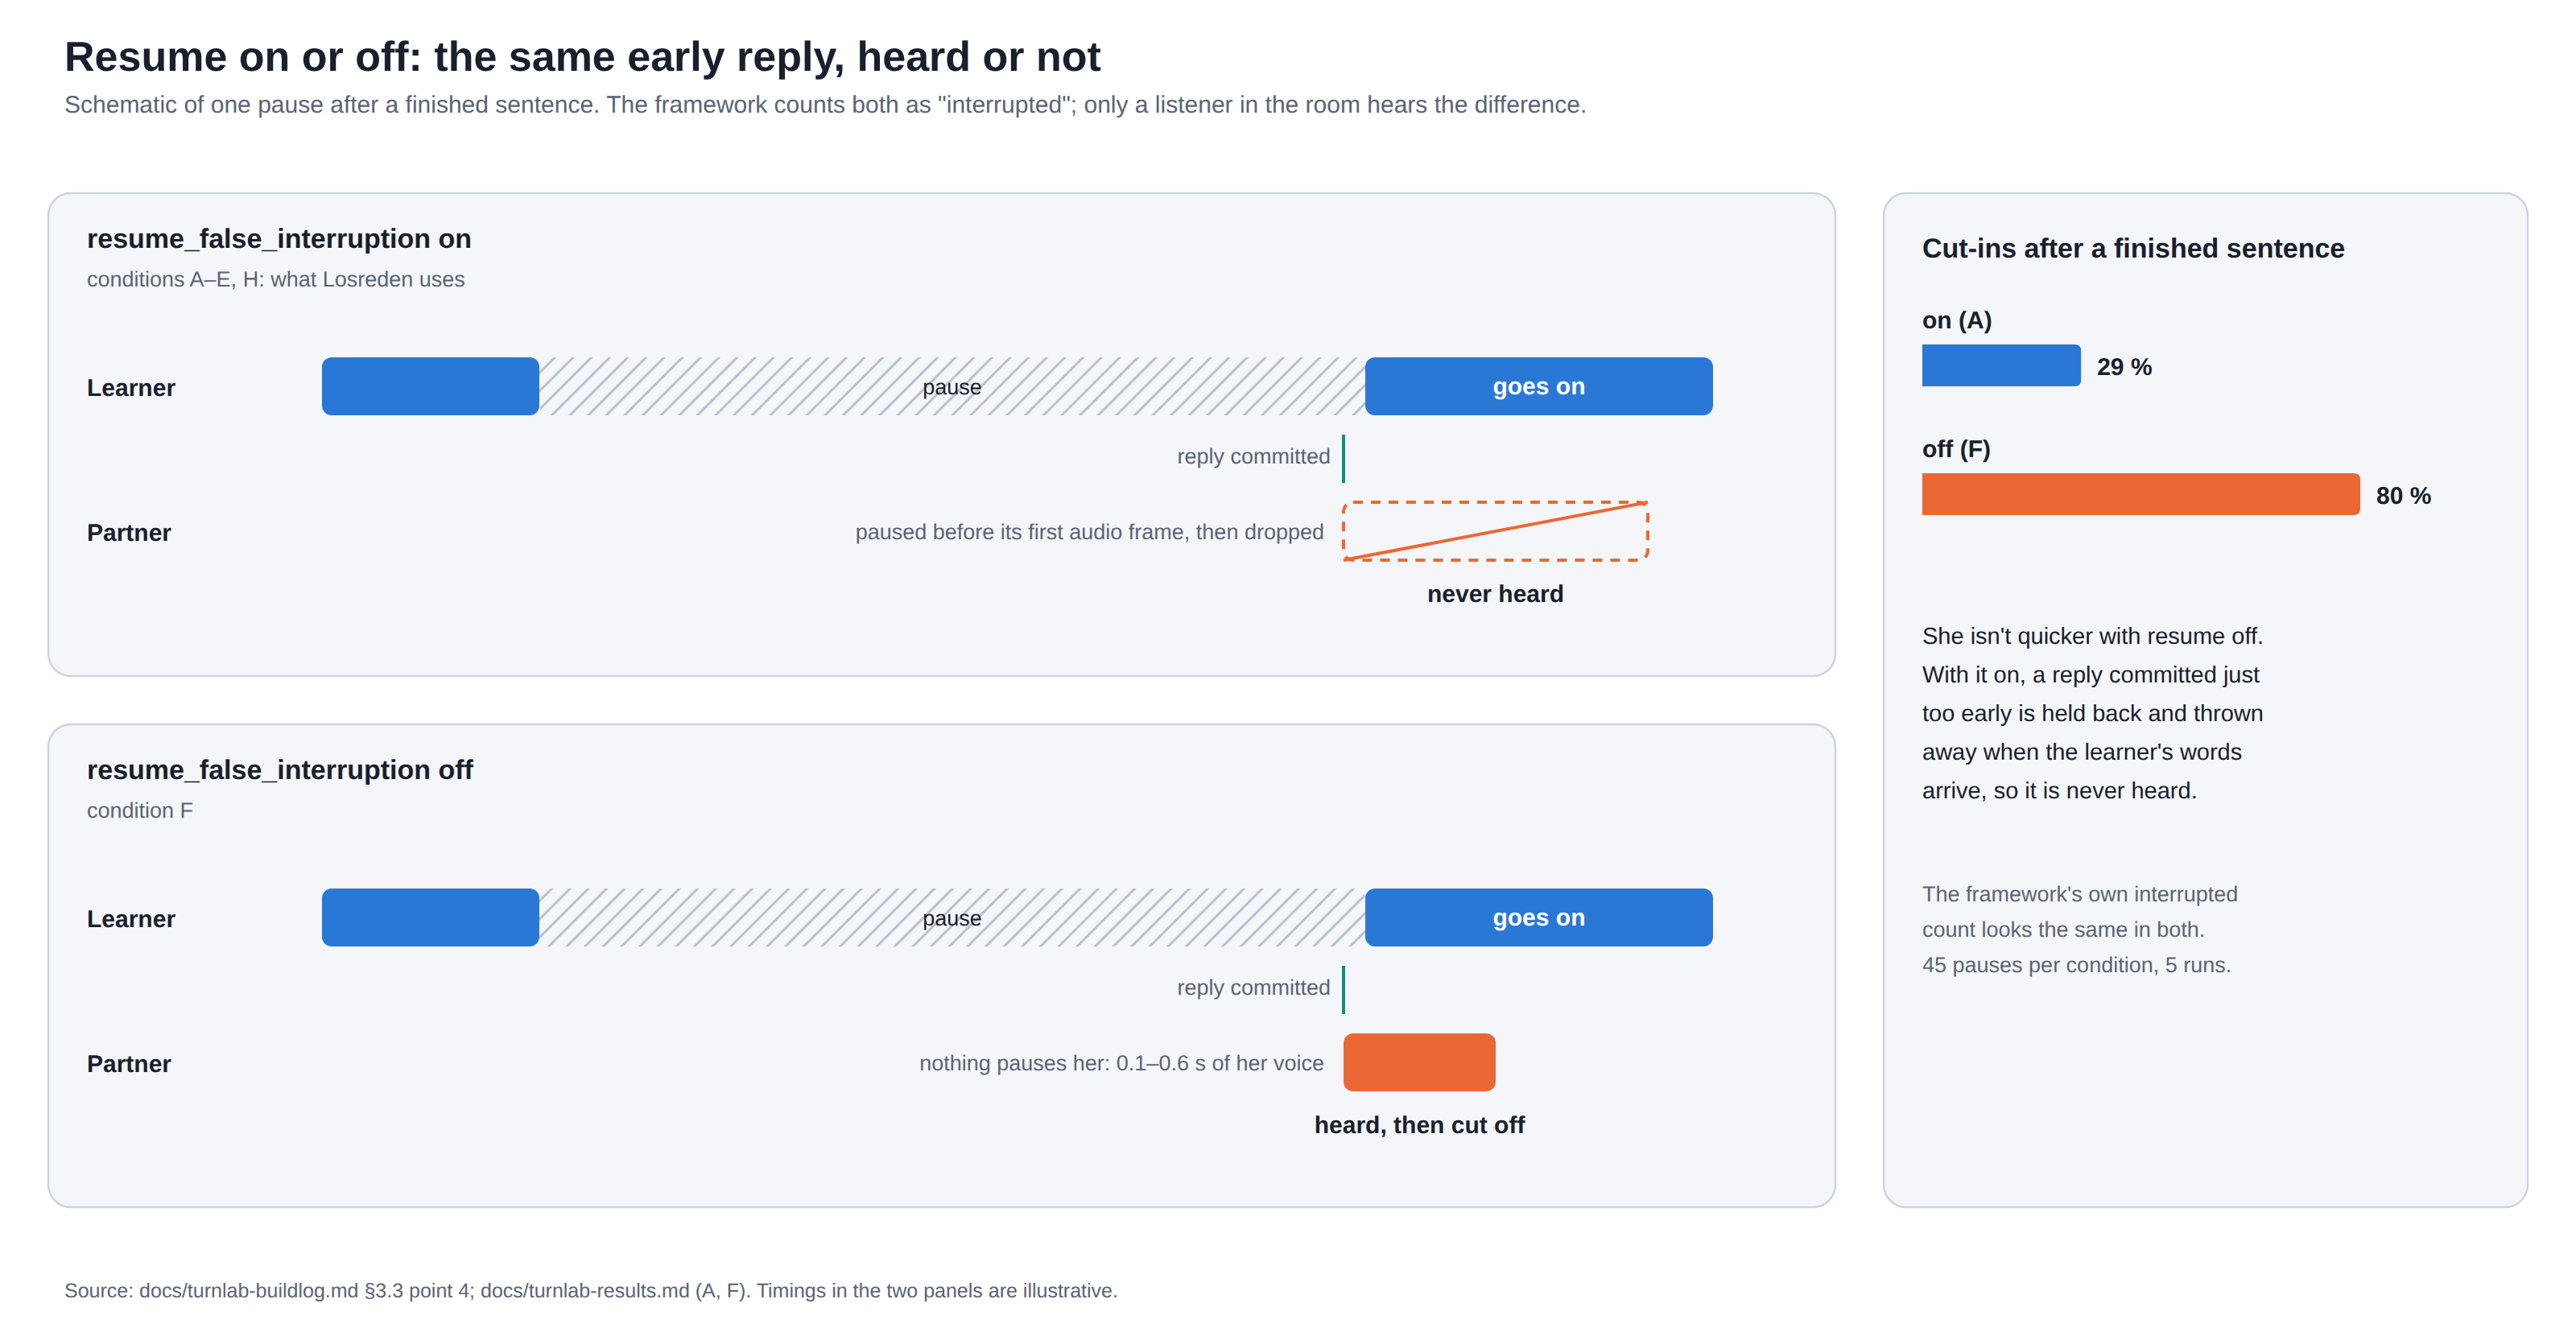
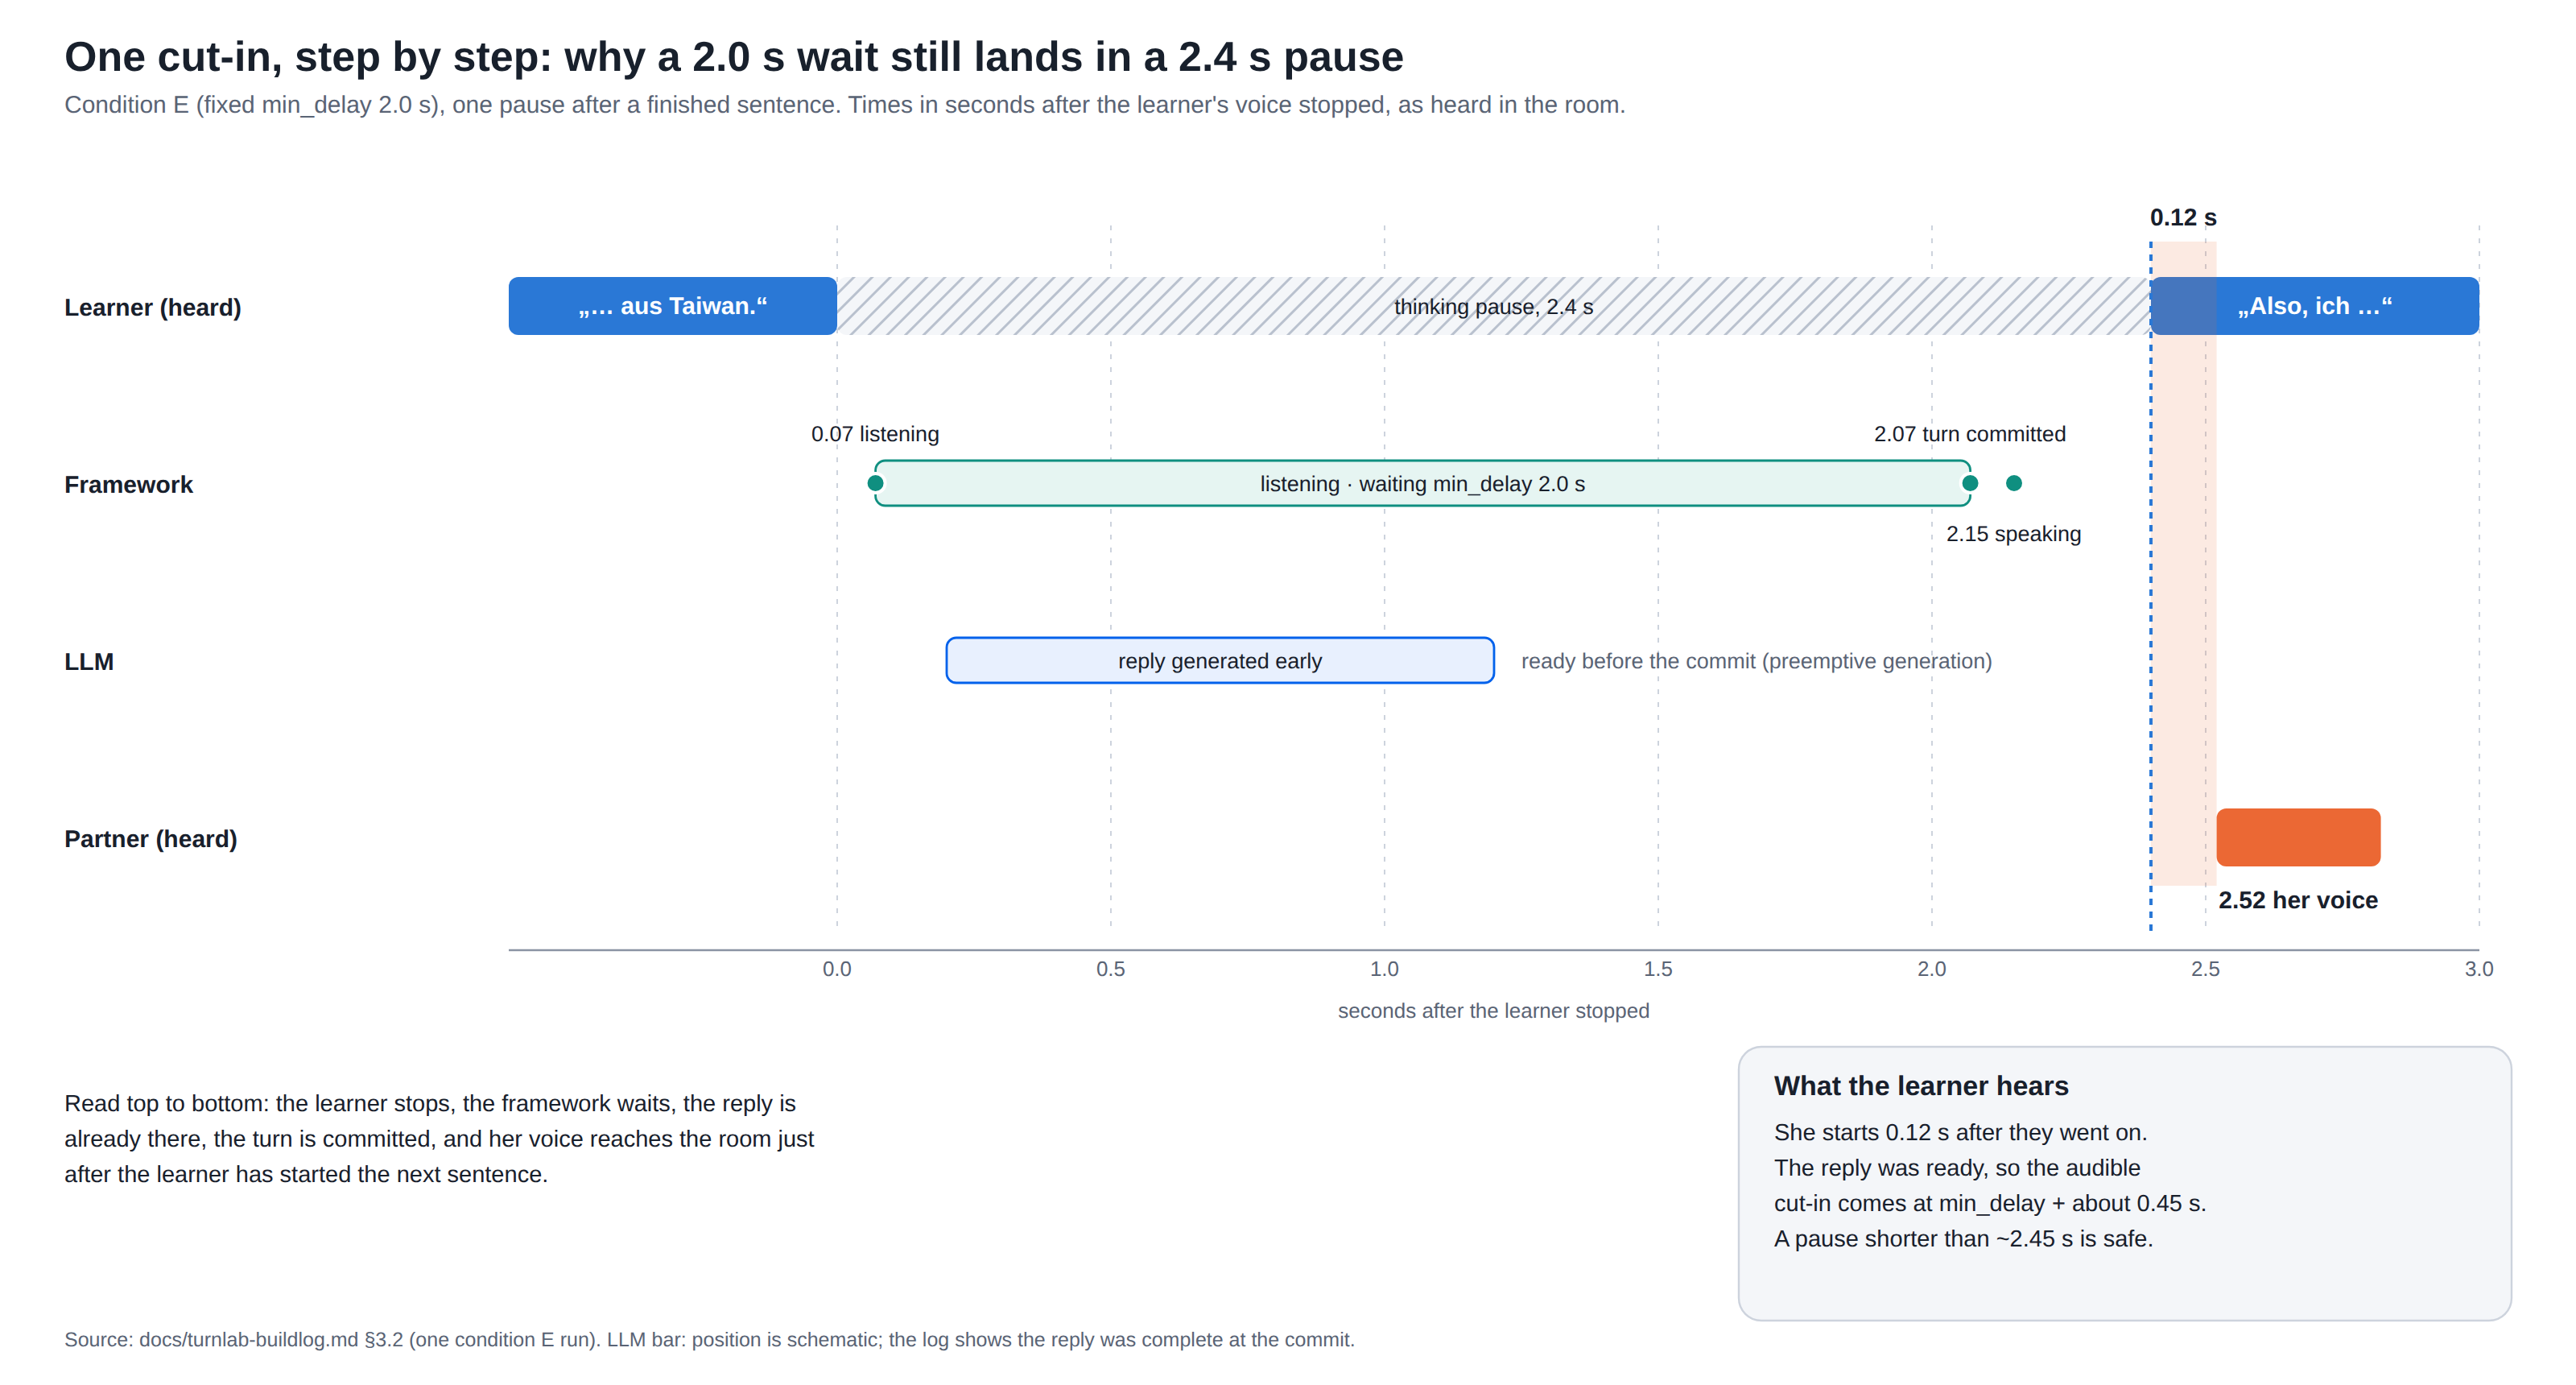
有一段時間軸說明了為什麼連 2.0 秒的 min_delay 也會切進 2.4 秒的停頓。學習者在 0.00 停下,框架的使用者狀態在 0.07 變成 listening,2.07 確定換人,2.15 agent 進入 speaking,2.52 聽到她的聲音,比學習者繼續開口晚了 0.12 秒。preemptive generation 讓回覆在確定換人時已經準備好,所以聽得到的搶話時間大約是 min_delay + 0.45 秒。
沒料到的發現:LLM 的速度是策略的一部分
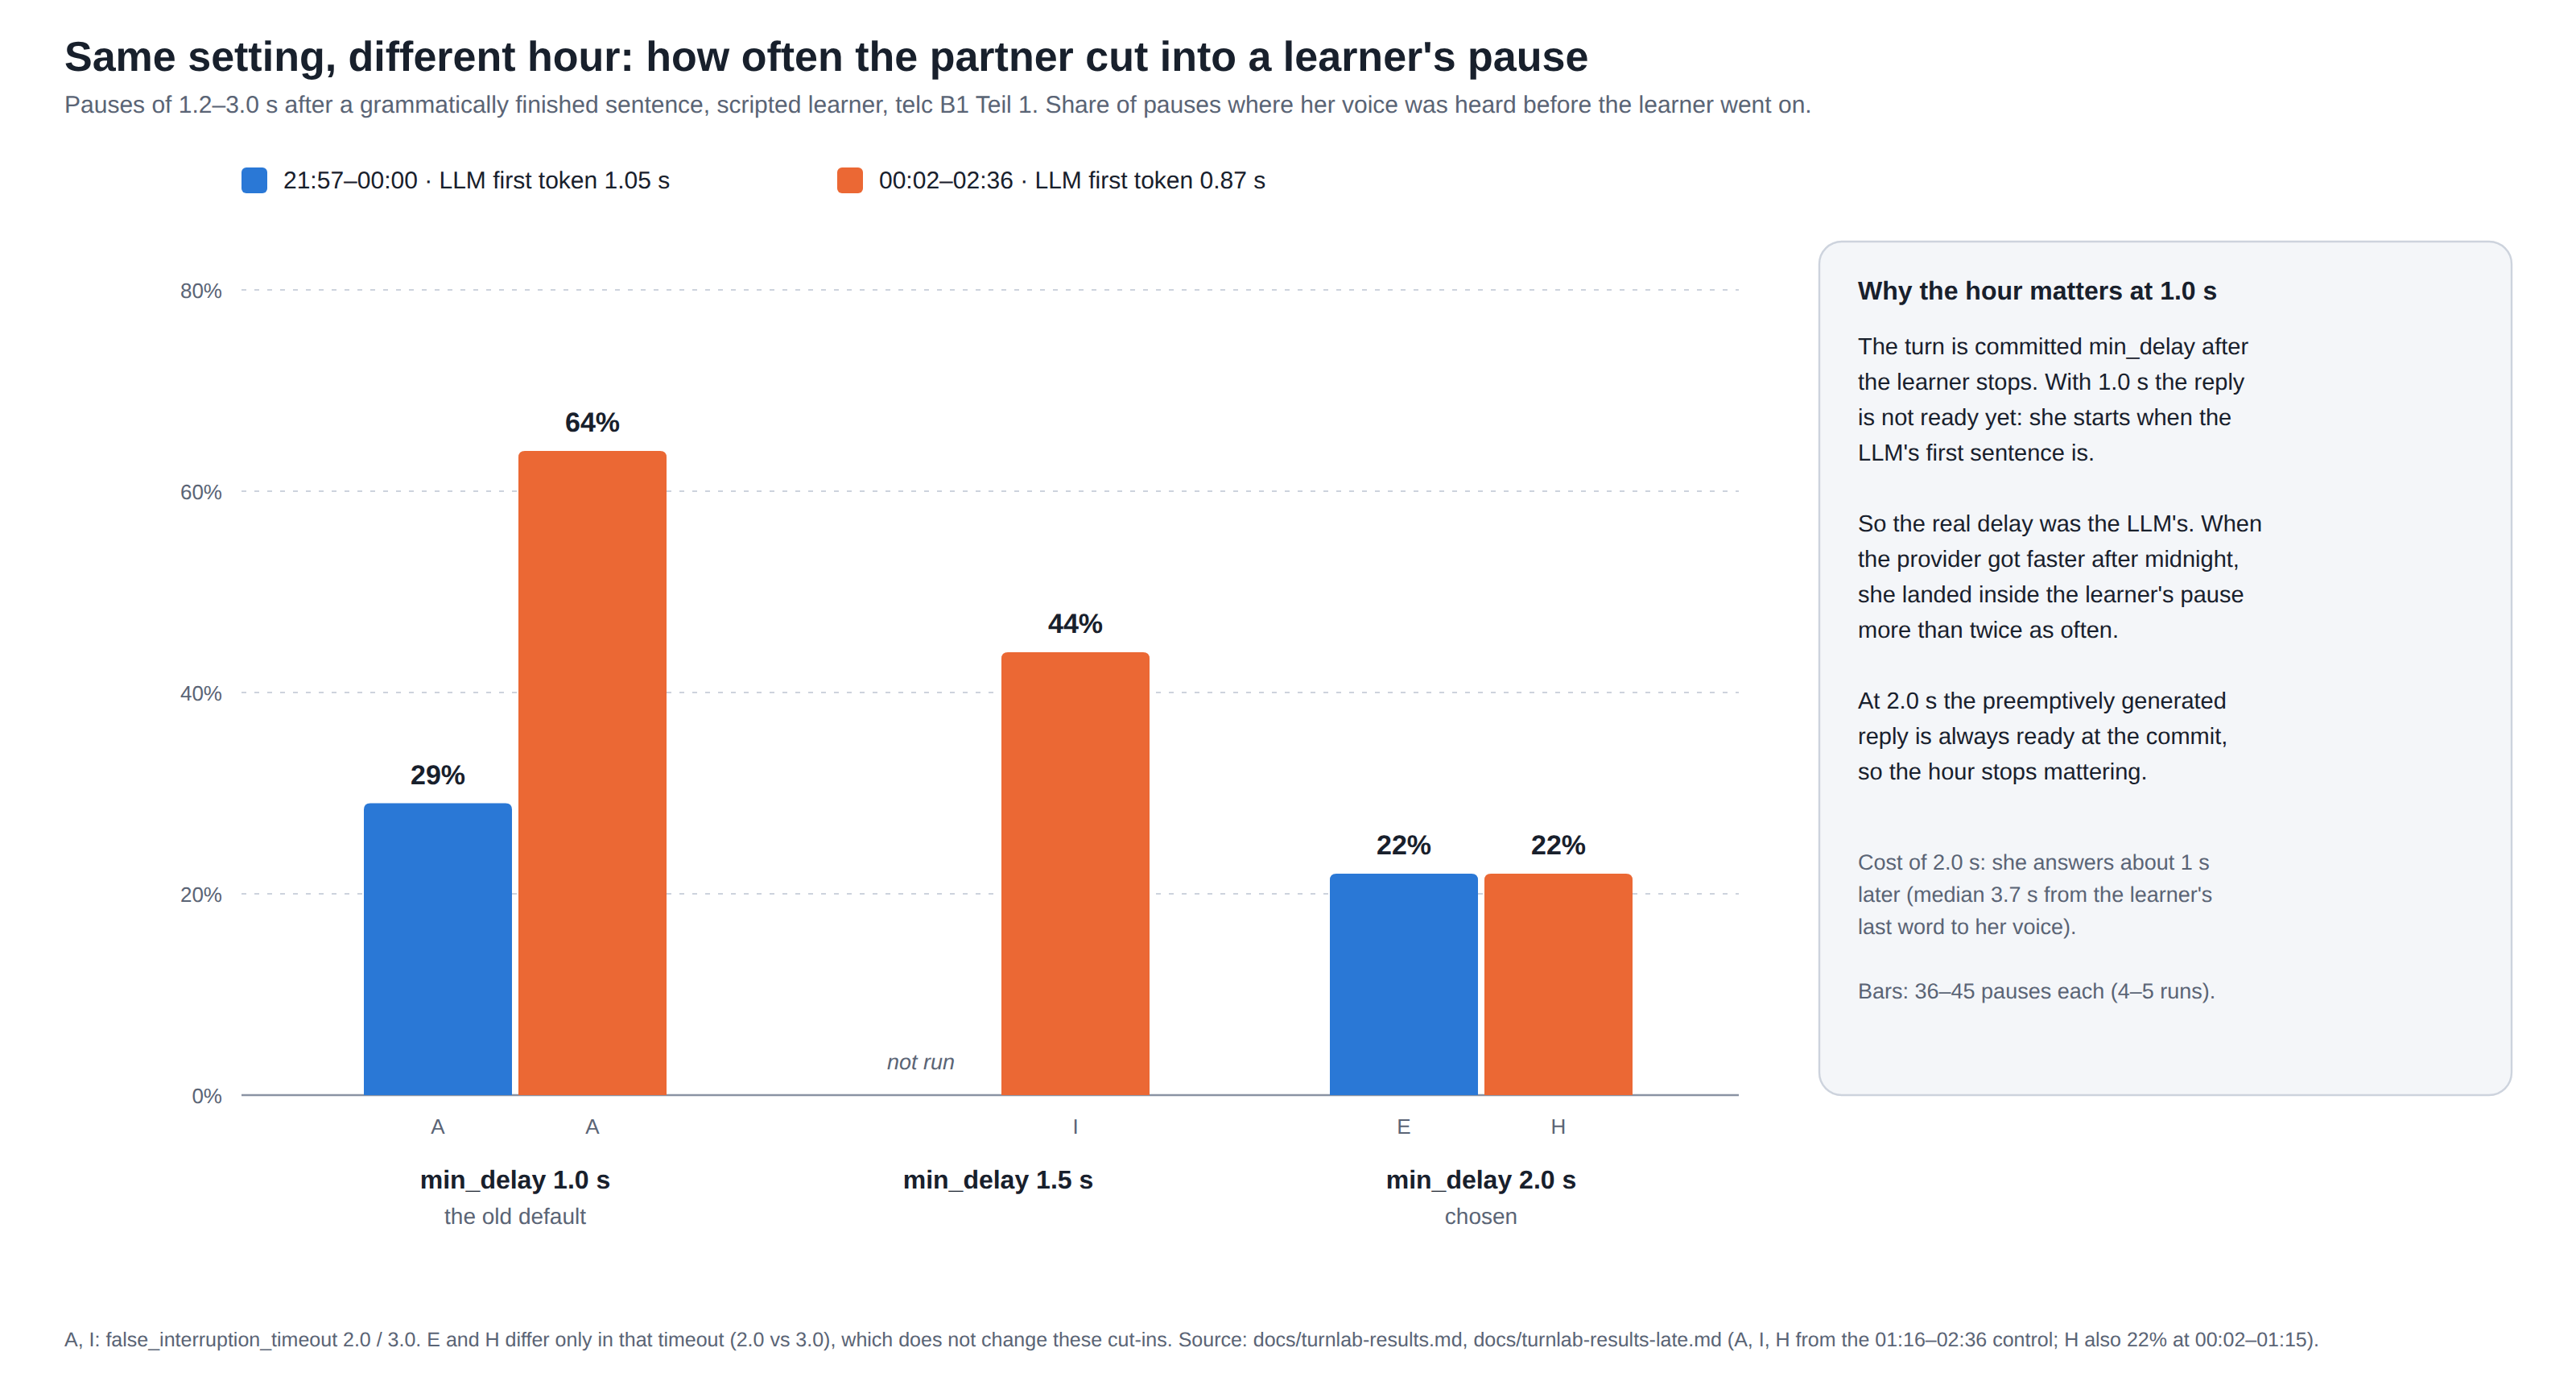
條件 G 在完整句子後打斷了 64 %,A 是 29 %。G 只多了比較長的 timeout,跟 endpointing 無關;C 對 B 也沒有這種跳升。差別在時段:A 到 E 是 21:57 到午夜,F 到 H 是 00:02 到 01:15。午夜之後,DigitalOcean Serverless Inference 上的 LLM 變快了,第一個 token 的中位數從 1.05 秒降到 0.87 秒。
所以我在同一個時段(01:16–02:36)做了對照:A、G、H,加上新的 I(固定 1.5 秒),交錯進行,每個 4 次。
| 設定 | 完整句子後被打斷 | 所有停頓 | 「Ähm」後蓋過 | 每次搶話她講了多久 | 間隔中位數 / p90 | |
|---|---|---|---|---|---|---|
| A | 舊設定:固定 1.0 秒,timeout 2.0 秒 | 64 %(午夜前 29 %) | 50 % | 100 % | 0.55 秒 | 2.64 / 6.60 秒 |
| G | 固定 1.0 秒,timeout 3.0 秒 | 61 % | 36 % | 25 % | 0.53 秒 | 2.72 / 6.57 秒 |
| I | 固定 1.5 秒,timeout 3.0 秒 | 44 % | 28 % | 25 % | 0.55 秒 | 3.10 / 5.82 秒 |
| H | 固定 2.0 秒,timeout 3.0 秒 | 22 % | 13 % | 17 % | 0.22 秒 | 3.68 / 6.37 秒 |
 本文的圖,文字都是英文。
機制是這樣的:min_delay 是 1.0 秒時,確定換人的那一刻回覆還沒準備好,因為它要約 1.05 秒。她在確定換人後約 1.2 秒才開口,學習者大約在停下後 2.7 秒聽到她。舊設定看起來很有耐心,其實是因為 LLM 慢。供應商一變快,她在確定換人後約 0.35 秒就開口,正好落在學習者的停頓裡。min_delay 是 2.0 秒時,提前生成的回覆在確定換人時一定已經好了,所以不管那個時段供應商多快,學習者都是在停下後約 2.7 秒聽到她。固定 2.0 秒在午夜前是 22 %(E),午夜後也是 22 %(H,兩個時段都是)。
給調這個參數的人: 如果 min_delay 比你的 LLM 第一個 token 還短,真正的等待時間就是 LLM 決定的,而且會隨供應商的負載變動。請在一天裡不只一個時段量。
我選了什麼,代價是什麼
telc:
  turn_taking: {mode: fixed, min_delay: 2.0, max_delay: 5.0}
  interruption: {mode: null, false_interruption_timeout: 3.0}
yaml- 固定,不用 dynamic。 dynamic 的起點比學習者需要的低,而且在 3–6 分鐘的部分裡學得太慢。dynamic 模式和延續機制都留在程式裡當選項。
- VAD 打斷,不用 adaptive。 學習者的填充詞不是附和。
- resume 保持開著。 就是它讓稍微太早的回覆根本不會被聽到。
- 代價: 她晚約 1 秒回答,從學習者最後一個字到她開口中位數 3.7 秒(p90 6.4 秒)。對考伴來說,寧可錯在這一邊;telc 自己的說法也是考官要讓考生說完。如果實際用起來太慢,下一步是 1.5 秒(條件 I),代價是搶話大約多一倍。
同一個時段裡,新設定打斷了 13 % 的停頓,舊設定是 50 %。學習者說「Ähm」之後,她蓋過去的比例是 17 %,舊設定是 100 %。這組設定在 2026-11-11 跑過一場完整考試確認後上線。
沒有涵蓋的部分。 一個聲音、一份腳本、一種題型,而且是合成學習者的乾淨音訊。真人學習者停的地方更多、更久。下一步是請老師評真人的逐字稿(見第一篇)。
我想向 LiveKit 提的建議
- 讓 dynamic endpointing 學到的值跨過
update_agent()保留下來,或在文件裡寫明它會重來。現在多 agent 的流程每次交接都會丟掉。 - 在文件裡寫明
min_delay是下限,不是實際的等待時間。 低於 LLM 第一個 token 的時間時,真正的等待由供應商的延遲決定,而且會隨時段變動。 - 打斷指標加一個「有沒有被聽到」的標記。 在第一個音框前就被暫停、丟掉的回覆,和使用者真的聽到的一樣算成
interrupted。有這個標記,大家不用自己搭 observer 也能看到 F 顯示的事。 - 補一句 adaptive interruption 和非母語語音的說明。 「Äh, ähm.」這種填充詞會被判成附和,對流利的人沒問題,對學習者不對。production 模式預設關閉是對的,但值得寫一句原因。
先讀原始碼,讓我沒去測一個本來就關著的設定;把時間軸印出來、不只看統計表,抓到了我自己的兩個 bug。至於我本來沒在找的那個結果,是換了一個時段重跑同樣的測試才出現的。