利益揭露:我是 DigitalOcean 的 Solutions Architect,所以文中提到 DigitalOcean 產品時,是「業內人的觀點」而非中立第三方——這些地方我都會明確標示,其餘分析則盡量保持廠商中立。以下皆為個人觀點。
這個實驗沒有評估或比較任何廠商的產品。下面用的 H100 價格(每 GPU 小時 4.41 美元)是 DigitalOcean 截至 2026-11-10 的牌價,所有結論都以 GPU 小時表示。
一般的印象是 GRPO 很貴,因為生成很貴:每個 prompt 要在 temperature 1.0 下取樣八個 rollout。在第一篇裡,GRPO 在一個 JSON 抽取任務上,要花 5 到 18 倍於純 SFT 的 GPU 小時才能達到相同品質。這篇談原因。我在 TRL 的各個方法外面加了計時器,並且每一步都記錄訓練訊號。
結果生成只占帳單約 5%。其餘都是 trainer 的時間,而且大多數步驟沒有教給模型任何東西。
TL;DR
- 生成加權重同步,只占 GRPO GPU 時間的 5.3%。 成本由 prompt 長度決定:每個 rollout 只生成約 44 個 token,卻要把約 327 個 token 的 prompt 在訓練模型裡跑三遍。
- backward pass 加 optimizer step 占 49%, 為了算 log-prob 的 no-grad forward 占 21%,grad forward 占 22%。
- 到訓練結束時,有 96% 到 98% 的 rollout 群組 reward 變異為零。 seed 0 裡,55% 有記錄的步驟梯度範數剛好是 0。
- 我試的兩個變體都沒有幫助: 只訓練困難 prompt,或在 SFT 用完所有標註之後再跑 GRPO。
- 有一個 seed 在死亡相關欄位崩潰成 null,而訓練 reward 幾乎沒動。 是 eval 曲線抓到的。每步記錄 null 率可以更早發現。
實驗設定,簡述
Qwen3-1.7B 加 LoRA r = 16,一張 H100 80GB,vLLM 和 trainer 共用 GPU。任務是維基百科人物傳記轉 5 欄位 JSON 紀錄,用 2,000 篇 held-out 文件上的 exact-record 準確率評分。GRPO 從準確率 0.865 的共同 SFT checkpoint 出發:每步 8 個 rollout × 16 個 prompt,temperature 1.0,最多生成 160 個 token,TRL 1.17.1 預設值(β = 0、loss_type="dapo"、開啟 vLLM importance-sampling 修正),lr 2e-5,1,200 步,上限 2.5 GPU 小時。完整的表在第一篇。
GPU 時間花到哪裡
在 TRL 各方法外面加計時,seed 0,總共 8,847 秒:
| GRPO 一步中的部分 | 秒數 | 占比 |
|---|---|---|
| vLLM 生成 | 393 | 4.4% |
| 權重同步到 vLLM | 79 | 0.9% |
_generate 其餘部分(tokenize、雜務) | 94 | 1.1% |
| reward 函式 | 18 | 0.2% |
| trainer 自己算 log-prob 的 no-grad forward | 1,861 | 21.0% |
grad forward(compute_loss) | 1,916 | 21.7% |
| backward pass 與 optimizer step | 4,360 | 49.3% |
| 載入模型、啟動 vLLM、存 checkpoint | 88 | 1.0% |
生成加權重同步是 5.3%,整個 _generate 是 6.4%。其他 GRPO run 的比例分布也相同,差距在一個百分點以內。
原因在 token 數量。每個 rollout 只生成約 44 個 token,但 prompt(傳記加指令)約 327 個 token,而訓練模型要把整段序列處理三遍:一次 no-grad forward、一次 grad forward、一次 backward。GRPO 讓訓練模型處理了 5,730 萬個 token,同一任務的 SFT 臂是 1,120 萬個,另外還生成了 680 萬個 token。
第一篇用的是玩具規模的任務,這裡的金額也是。能帶走的是公式:一步的成本隨 prompt token 數 × rollout 數 × 三次 trainer pass 而增加,而不是隨 completion 長度。
沒有人要求的那次 no-grad forward
這次 no-grad forward 只為了 vLLM 的 importance-sampling 修正而存在,而這個修正預設是開的。在 β = 0 且每批資料只跑一次迭代的條件下,沒有別的東西用到那些 log-prob。關掉修正,大約可以省下 GRPO 五分之一的時間,第一篇的倍數也會縮小同樣的五分之一,但不會被補平。
我沒有測這一點。這個修正是有理由的:沒有它,GRPO 訓練用的樣本來自一份數值行為和 trainer 不同的 vLLM 副本,這可能改變它學到的東西。請把 21% 當成可節省幅度的上限,不要當成建議。
為什麼停滯:大多數群組沒東西可學
GRPO 只從「8 個 rollout 拿到不同 reward」的群組學習。共同 checkpoint 在大多數文件上已經答對,而且在 temperature 1.0 下幾乎是確定性的:我取樣 DPO 配對時,10,000 個文件池 prompt 裡有 6,324 個,4 個樣本全部完全正確。
| GRPO run | 零變異群組占比,前/中/後 10% 步數 | entropy,起點到終點 |
|---|---|---|
| seed 0 | 80% / 97% / 98% | 0.0045 到 0.0007 |
| seed 1 | 70% / 95% / 96% | 0.0071 到 0.0009 |
| 只用困難 prompt | 54% / 91% / 94% | 0.0105 到 0.0010 |
| 接在 Arm A 之後 | 84% / 97% / 96% | 0.0029 到 0.0006 |
seed 0 有記錄的 240 步中,有 131 步(55%)的梯度範數剛好是 0。那一步的 16 個 prompt 全都得到 8 個相同的 reward,所以這一步什麼都沒改變,卻照樣付了三次 trainer pass 的成本。從 1.1 GPU 小時到結束的 2.46,seed 0 都落在 0.8675 到 0.876 之間。最後 15 個 checkpoint 的讀數是 0.872 到 0.873。
兩個沒有幫助的變體
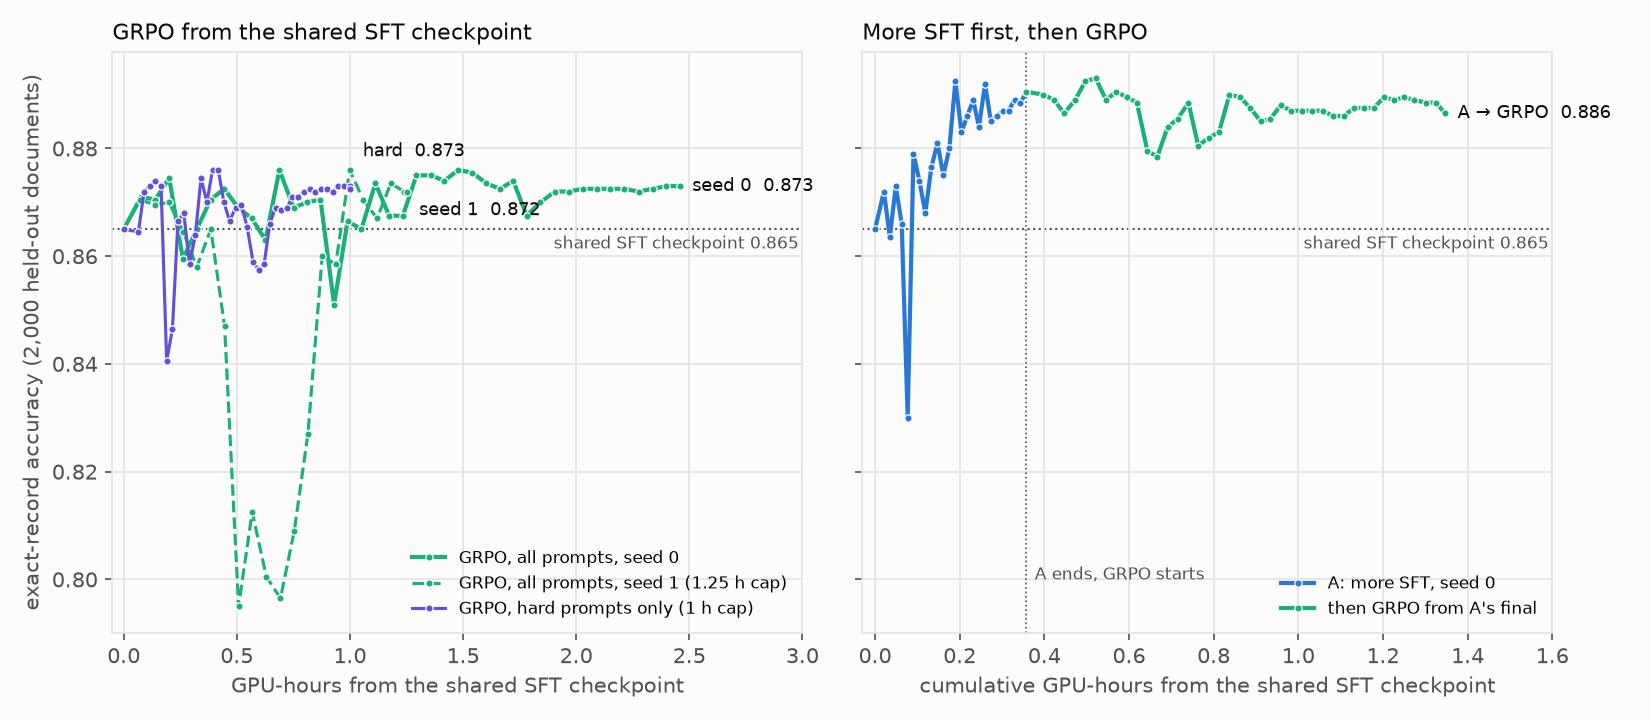
- 只用困難 prompt。 訓練只用 3,676 個「4 個 SFT 樣本中至少有一個答錯」的 prompt,配對取樣成本照算。最終 0.8725(最好 0.876),和用全部 prompt 的 GRPO 一樣。它的零變異占比起點較低(54%),最後仍然到 94%。篩選 prompt 只是延後訊號消失,無法阻止。
- 在更多 SFT 之後才跑 GRPO。 這測的是另一個分支點:SFT 已經用完所有標註之後。GRPO 從 Arm A 的最終 checkpoint(0.8905)開始。一個 GPU 小時,最好 0.893(修正 18、搞砸 13,p = 0.47),最終 0.8865(修正 9、搞砸 17,p = 0.17)。從共同 checkpoint 算起共 1.35 GPU 小時,相比只做 SFT 沒有顯著變化。
訓練 reward 沒有顯示的崩潰
seed 1 在訓練中途出了問題。第 240 步(0.51 GPU 小時)時 exact-record 掉到 0.795,非 null 的 recall 是 0.871、precision 是 0.982。模型開始對內文明明有支持的欄位回傳 null。我逐欄位數了「gold 有值、輸出卻是 null」的次數:
| gold 非 null、輸出為 null | 第 150 步 | 第 240 步 | 第 606 步(結束) | gold 非 null 總數 |
|---|---|---|---|---|
| death_place | 39 | 131 | 28 | 136 |
| death_date | 1 | 181 | 1 | 258 |
| birth_place | 97 | 176 | 106 | 750 |
| birth_date | 0 | 13 | 0 | 1,158 |
在最低點,模型對 136 個死亡地點中的 131 個、258 個死亡日期中的 181 個回答 null,出生地則有 750 個中的 176 個,第 150 步時是 97 個。這就是我預測過的失敗模式:gold 有值時回 null,得分比答對低,但低得不多,policy 是慢慢漂進去的,而不是因為被獎勵才走進去。我不會把它稱為嚴格意義的 reward hacking。
它在沒有任何介入的情況下恢復了:0.999 GPU 小時時 0.876,結束時 0.872。整段崩潰期間訓練 reward 幾乎沒動,維持在 0.95 到 0.98,因為一個缺漏欄位只讓一篇文件少 0.16,而死亡相關欄位只在一小部分文件裡非 null。我每 100 步存一次、每次 128 個 rollout 的樣本,也只隱約看得出來。真正抓到的是 eval 曲線。
每個訓練步驟逐欄位記錄 null 率,就能在訓練當下抓到。如果你在結構化輸出的任務上跑 GRPO,而且某個欄位大多是 null,這一行記錄是便宜的保險。
什麼情況會改變答案
- Prompt 與 completion 的比例。 這裡的成本是每個 rollout 約 371 個 token 上的三次 trainer pass。對於 prompt 短、completion 長的任務(例如推理軌跡),生成占的比例會上升,上面的組成就不成立。
- 起點的位置。 有 80% 到 98% 的群組沒有梯度,GRPO 在這裡缺乏訊號。起點更弱(base model 是 0.7055)或任務更難,會有更多混合結果的群組。我沒有從 base model 跑 GRPO。
- 標註。 reward 是拿 gold 紀錄算的,和 SFT 拿到的資訊相同。沒有標註時 SFT 用不了,GRPO 才有它的工作。
- 獨立的 vLLM 伺服器。 生成可以和訓練重疊,但要占用第二張 GPU,這改變的是帳的算法,不是運算量。
成本
GRPO seed 0 的 run 花了 2.46 GPU 小時,以每小時 4.41 美元計是 10.84 美元。SFT 臂用 0.358 GPU 小時就達到更高品質,成本 1.58 美元。絕對數字小是因為任務小,機制則不會變:GRPO 一步的成本隨 prompt token 數 × rollout 數 × 三次 trainer pass 而增加,而它的收益受限於有多少 rollout 群組的結果不一致。
我估錯的地方
- 樣本傾印太小。 每 100 步 16 個 prompt,看不清楚 seed 1 死亡欄位的崩潰。null 率記錄就能看清楚。
- 訓練 reward 在最糟的時段看起來很健康。 我把 reward 當成主要的健康指標。在稀疏欄位上,它不是。
- 我對 reward hacking 的預測,作為對結果的陳述是錯的。 我預測的失敗在一個 seed 的中途出現,到最終 checkpoint 又消失了。這種短暫的行為,只有經常做 eval 才看得到。
限制
- 一個任務、一個模型、一張 GPU, 而且 vLLM 與訓練共用 GPU。5.3% 的生成占比取決於 completion 很短的任務。
- 兩個 seed, 而 seed 1 在 1.25 GPU 小時上限下,於第 606 步停止。
- 沒有超參數搜尋。 GRPO 用的是 TRL 預設值。不同的群組大小、temperature 或 learning rate,可能改變群組帶有訊號的頻率。
- 計時量到的是 TRL 的方法, 不是底下的 CUDA kernel。backward 與 optimizer 的 49.3% 是扣掉其他計時之後的剩餘,不是獨立量測。
- 上面的逐欄位 null 計數,是用儲存下來的逐文件 eval 輸出,對照 held-out 的 gold 標註算出來的。
程式碼、設定檔和每一步的 log:github.com/iambigmomma/post-training-cost-curves-v2。