利益揭露:我是 DigitalOcean 的 Solutions Architect,所以文中提到 DigitalOcean 產品時,是「業內人的觀點」而非中立第三方——這些地方我都會明確標示,其餘分析則盡量保持廠商中立。以下皆為個人觀點。
這個實驗沒有評估或比較任何廠商的產品。成本換算用的 H100 價格(每 GPU 小時 4.41 美元)是 DigitalOcean 截至 2026-11-10 的牌價。文中所有結論都以 GPU 小時表示,不受這個價格影響。
後訓練(post-training)方法的比較通常用步數或 epoch 對齊,但這會掩蓋預算負責人真正付錢的東西。一個 GRPO 步驟和一個 SFT 步驟的工作量完全不同,所以我把三種方法放到同一條軸上,也就是一張 H100 上的 GPU 小時,問的是:要達到某個品質,各自要花多少。
從同一個 exact-record 準確率 0.865 的 SFT checkpoint 出發,繼續 SFT 花 0.36 GPU 小時到 0.8905。GRPO 花 2.46 小時到 0.873。DPO 最後是 0.8525,比起點還低。兩個 seed 的排序一致。
這是這個實驗的兩篇文章中的第一篇。第二篇談 GRPO 的 GPU 時間花到哪裡,以及它為什麼會停滯。
TL;DR
- 實驗: Qwen3-1.7B 加 LoRA,一個任務(維基百科人物傳記轉成 5 欄位 JSON 紀錄),三個臂都從同一個 SFT checkpoint 分支:繼續 SFT(A)、SFT 後接 DPO(B)、SFT 後接 GRPO(C)。成本是訓練程序在一張 H100 上的牆鐘時間。兩個 seed,2,000 篇 held-out 文件。
- 同樣花費下,繼續 SFT 領先 GRPO 2.55 分(0.358 GPU 小時時 0.8905 對 0.865,McNemar p = 0.0002)。
- 達到同樣品質,GRPO 要花 5 到 18 倍的 GPU 小時(要求它「之後都維持在這個水準」,倍數依 seed 而定)。2.46 小時內它從未到達 0.8905(最好的 checkpoint 是 0.876)。
- DPO 在兩個 seed 都掉了品質。 偏好指標在進步,gold 答案卻變得更不可能被生成。
- 這是「有標註」情境下的結果。 這裡 GRPO 的 reward 是拿 SFT 訓練用的同一批 gold 紀錄來算的。沒有標註、reward 只能檢查結構的情境,也就是 GRPO 真正有用武之地的情境,這次沒有測。
實驗設定
| 任務 | 維基百科人物傳記(WikiBio 導言段,40 至 300 字)→ JSON 紀錄 {name, birth_date, birth_place, death_date, death_place},日期為 ISO 格式或 null |
| 模型 | Qwen3-1.7B,非思考模式,LoRA r = 16 套在所有線性層,bf16 |
| 共同起點 | 用 2,000 篇標註文件做 SFT,2 個 epoch:base model 0.7055,之後 0.865 |
| Arm A | 用 10,000 篇文件池繼續 SFT,3 個 epoch,lr 2e-4 |
| Arm B | 用文件池建出的 3,676 組配對做 DPO(chosen = gold 紀錄,rejected = 4 個 SFT 樣本中最差的),β 0.1,lr 1e-5。配對取樣的成本算在 B 上 |
| Arm C | 用文件池的 prompt 做 GRPO,每步 16 個 prompt × 8 個 rollout,vLLM 和訓練共用 GPU,TRL 1.17.1 預設值,lr 2e-5,1,200 步,上限 2.5 GPU 小時 |
| Reward | 規則式:schema 正確性、5 個欄位答對的比例、沒有內文依據的值要扣分。它是拿 gold 紀錄來比對 |
| 指標 | 2,000 篇 held-out 文件上的 exact-record 準確率(5 個欄位全對),greedy decoding |
| 成本 | 訓練程序在一張 H100 80GB 上的牆鐘時間,包含載入模型。eval 不計入 |
| 顯著性 | 以每篇文件配對的 McNemar 精確檢定,p < 0.05 |
輸出慣例直接寫在 prompt 裡,所以 policy 原則上可以靠試錯發現它們。我這樣設計是為了讓 GRPO 有公平的機會。我先前有一次獨立的實驗(Qwen2.5-1.5B,意圖與槽位解析)得到相同的排序:從 0.640 出發,繼續 SFT 到 0.743,GRPO 到 0.662,DPO 掉到 0.502。
曲線:A 往上,GRPO 停在平台,DPO 往下
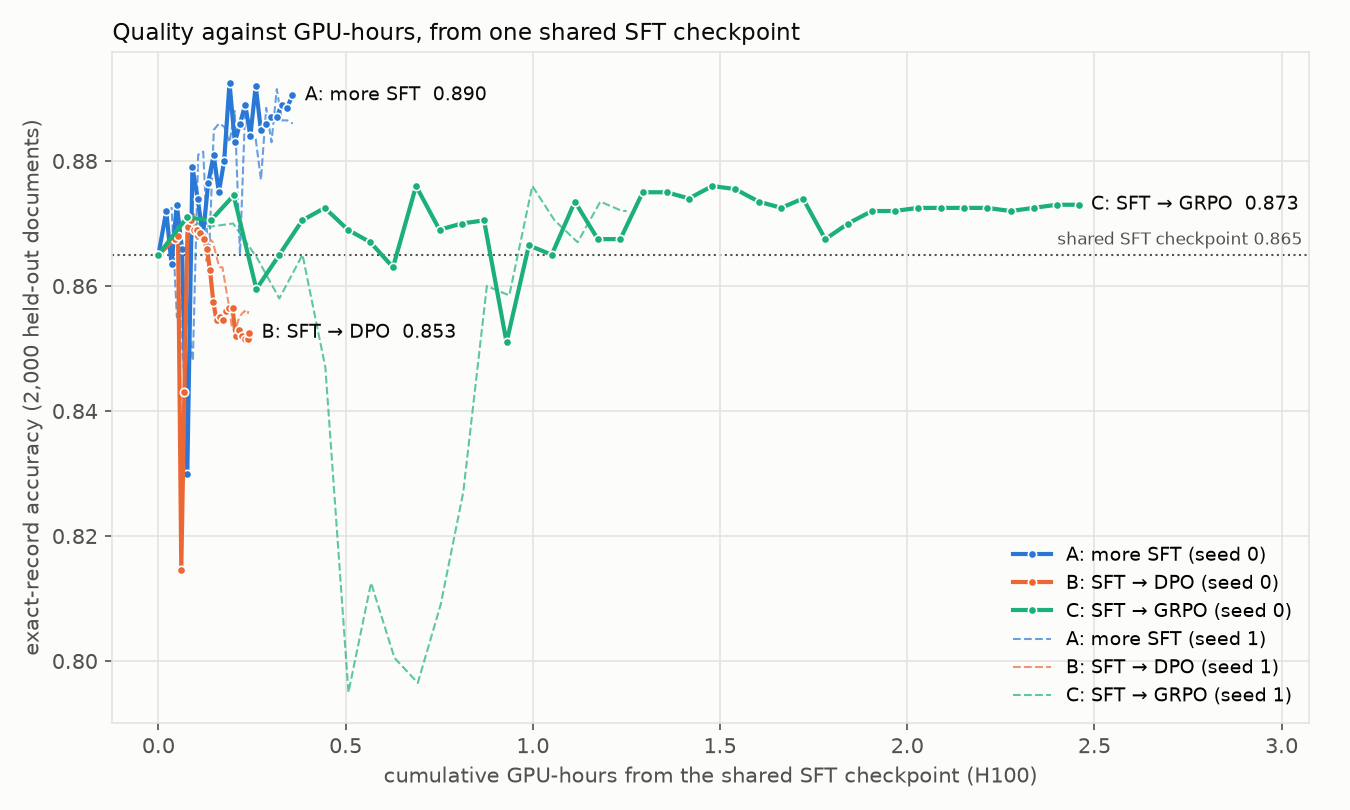
實線是 seed 0,虛線是 seed 1。每個點都是一個 checkpoint 在同一組 2,000 篇文件上的成績。放大圖涵蓋前 0.36 GPU 小時,也就是 Arm A 和 DPO 的整段訓練:
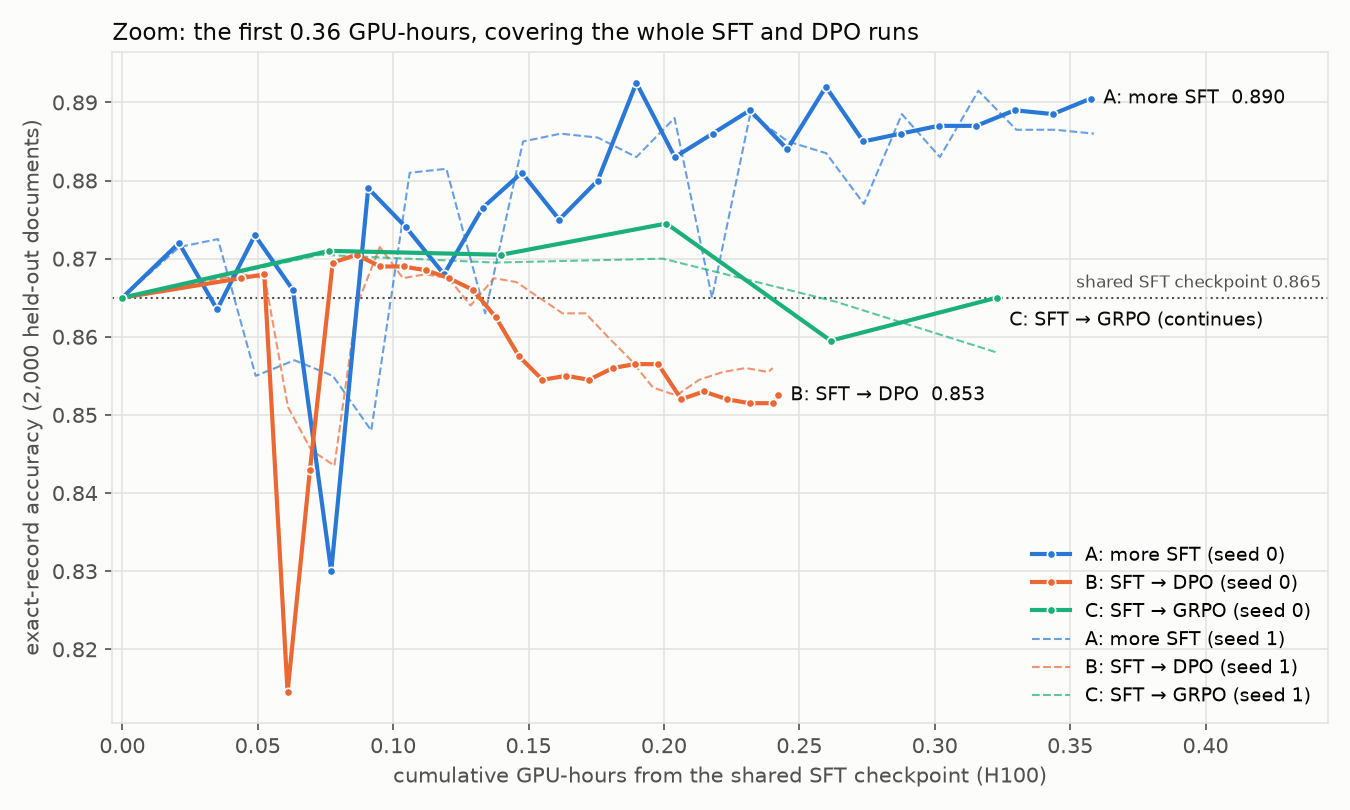
同樣花費下,領先 2.55 分
每一臂都取預算內最新的 checkpoint:
| 預算 | Arm A | GRPO | DPO | A 對 GRPO(A 較好/GRPO 較好,p) |
|---|---|---|---|---|
| 0.242 h(DPO 全部花費),seed 0 | 0.889 | 0.8745 | 0.8525 | 83 / 54,p = 0.016 |
| 0.358 h(A 全部花費),seed 0 | 0.8905 | 0.865 | 0.242 h 已結束 | 117 / 66,p = 0.0002 |
| 0.359 h(A 全部花費),seed 1 | 0.886 | 0.858 | 0.240 h 已結束 | 131 / 75,p = 0.0001 |
逐一比較 Arm A 每個 checkpoint 對應的預算:seed 0 的 25 個預算中,A 有 10 個顯著領先 GRPO;seed 1 是 25 個中有 16 個。GRPO 顯著領先的分別只有 1 個和 2 個,三個都落在 0.07 至 0.10 GPU 小時之間,這段時間兩個 seed 的 Arm A 都出現下滑(seed 0 是 0.830)。下滑時 Arm A 會在 gold 為 null 的地方填上 birth_place。到 0.11 GPU 小時它就回到 GRPO 之上。曲線沒有交叉:GRPO 從來沒有取得一個能保持住的領先。
同樣品質下,要多花 5 到 18 倍 GPU 小時
倍數取決於「達到」的定義。我只在某一臂從此之後都維持在目標之上時才算它達到:
| 品質目標 | Arm A | GRPO | 倍數 |
|---|---|---|---|
| 0.873(GRPO seed 0 的最終值) | 0.133 h | 2.399 h | 18 倍 |
| 0.872(GRPO seed 1 的最終值) | 0.232 h | 1.180 h | 5.1 倍 |
| 0.8905(Arm A 的最終值) | 0.190 h | 從未達到(任何 GRPO 的最佳值:0.876) | 未達到 |
比較寬鬆的「第一次碰到」定義,在 seed 0 是 4.1 倍,在 seed 1 是 28 倍。我兩個都不拿來當依據。seed 0 裡 GRPO 第一次碰到 0.873,只比它的起點高 0.8 分,落在單一 checkpoint 一個標準誤(2,000 篇文件上約 0.75 分)之內。seed 1 的 GRPO 有 0.5 至 0.9 GPU 小時處在第二篇會談到的崩潰裡,這會把「第一次碰到」的數字撐大。
GRPO 的最終值在兩個 seed 都高於起點,但幅度不大:+0.8 分,seed 0 的 p = 0.036,seed 1 的 p = 0.065。
DPO 為什麼掉了品質
兩個 DPO seed 都出現 likelihood displacement。DPO 拉開 chosen 和 rejected 兩個答案的差距,主要靠把 rejected 往下壓,而 gold 答案也跟著下降:
| DPO,前 10% 步數到後 10% 步數 | seed 0 | seed 1 |
|---|---|---|
| chosen(gold)平均 log-prob | −1.69 到 −3.73 | −1.72 到 −3.58 |
| rejected 平均 log-prob | −3.65 到 −9.91 | −3.51 到 −9.81 |
| 偏好準確率 | 0.58 到 0.69 | 0.53 到 0.70 |
偏好指標在進步,模型在任務上卻變差。在 eval 集上,新增的錯誤大多是地點。seed 0 裡漏掉的出生地從 110 增加到 120,答錯的出生地從 55 增加到 80,漏掉的死亡地從 23 增加到 41。DPO 最好的 checkpoint 在兩個 seed 都出現得很早(0.087 h 的 0.8705,0.095 h 的 0.8715),兩者都沒有顯著高於起點。只看偏好準確率的儀表板,會顯示一路穩定進步。
成本換算
本次實驗實際計費的 GPU 小時,以每 H100 小時 4.41 美元計:
| 要達到 | Arm A | GRPO |
|---|---|---|
| 0.873,且之後維持 | 0.133 h,$0.59 | 2.399 h,$10.58 |
| 0.8905(Arm A 的最終值) | 0.358 h,$1.58 | 2.46 h 內未達到(整個 run $10.84) |
整個實驗約計費 6.9 GPU 小時,大約 30 美元。絕對數字小,是因為任務本身小。能帶走的是倍數和它的成因,第二篇會把成因拆開來看。
什麼情況會改變答案
- 標註。 這裡 GRPO 的 reward 是拿 gold 紀錄來算的,所以 GRPO 和 SFT 拿到的資訊一樣。如果文件池沒有標註、reward 只能檢查 schema 和是否有內文依據,Arm A 就不存在了。那才是 GRPO 有理由被使用的情境,而這個實驗沒有測它。
- 起點的位置。 共同起點在大多數文件上已經答對,GRPO 有 80% 到 98% 的 rollout 群組沒有產生梯度(第二篇)。起點更弱或任務更難,會給它更多訊號。我沒有從 base model 跑 GRPO。
- Arm A 的 learning rate。 早期下滑是 GRPO 唯一領先的預算區間。降低 SFT 的 learning rate 或拉長 warmup,大概就能消掉,那會讓我其中一個預測從「錯」變成「對」。我沒有測。
- Arm A 的分支位置。 五倍的標註只讓 Arm A 多了 2 到 3 分,所以分支點已經接近 SFT 的平台。我也從 Arm A 曲線頂端接著跑 GRPO:一個 GPU 小時,最好 0.893,最終 0.8865,和只做 Arm A 相比沒有顯著差異。
預測,逐項計分
我在任何訓練步驟開始之前就把十個預測寫進檔案並 commit。六個成立,兩個錯,兩個只在一個 seed 成立。錯的兩個:
- 我預測 Arm A 在相同 GPU 小時下不會顯著低於 GRPO。 實際上有:seed 0 在 1 個預算,seed 1 在 2 個預算,全都落在 Arm A 的早期下滑裡。
- 我預測若有 reward hacking,會以 null 的形式出現,也就是 recall 下降、precision 上升。最終 checkpoint 上沒有。seed 1 在訓練中途確實出現了這個型態,然後恢復。對失敗模式的判斷是對的,但作為對結果的陳述是錯的。
兩個失誤都來自短暫的行為:Arm A 的下滑只持續一兩個 checkpoint,GRPO seed 1 的崩潰約六個。checkpoint 少一點的曲線可能兩個都會漏掉。
我估錯的地方
- 吞吐量。 我用先前 1.5B 模型的數字,估 SFT 約 18k token/s,實際跑出來約 7.4k。GRPO 原本規劃的 2,000 步縮成 1,200 步,這樣它的 cosine schedule 才能在上限內跑完。
- 我第一版的同預算表只做到 DPO 結束的位置(0.24 GPU 小時),漏掉 0.24 至 0.36 這段 Arm A 領先最多的區間。我第一版的放大圖把 Arm A 標在中間的 checkpoint,讓那個數字看起來像最終值。兩者都在寫這篇之前修正了。
- 估算。 我預算了約 9.4 GPU 小時,實際計費約 6.9。
限制
- 一個任務、一個模型、一張 GPU。 全量微調或更大的模型,可能改變每步成本和天花板。
- 沒有對任何一臂做超參數搜尋。 Arm A 的 lr、DPO 的 β 與 lr、GRPO 的 TRL 預設值都是事先固定的。比較的是合理的預設值,不是各自的最佳情況。
- 兩個 seed, 而 GRPO seed 1 是較短、被上限截斷的 run,在 1,200 步排程的第 606 步就停了。
- 標註雜訊決定天花板。 每一臂約 90% 的錯誤欄位是地點。標註來自維基百科 infobox,再用內文過濾。很多地點錯誤是內文提到某個地點而 infobox 沒有,或地點片段多一個或少一個逗號段。GRPO 的 reward 繼承了同樣的雜訊。
- 成本時鐘是一張 GPU 上單一程序的牆鐘時間,vLLM 與訓練共用。如果 vLLM 獨立跑在另一張 GPU,GRPO 的帳會改變:生成可以和訓練重疊,但要用掉第二張 GPU。
- 統計檢定力。 單一 checkpoint 的標準誤約 0.75 分,所以每一個宣稱顯著的結論都用配對的 McNemar 檢定,而不是比較兩個分數。
程式碼、設定檔、每個 checkpoint 的成本和每篇文件的輸出:github.com/iambigmomma/post-training-cost-curves-v2。資料衍生自 WikiBio(Lebret、Grangier 與 Auli,2016),文字來自維基百科,採 CC BY-SA 3.0 授權。